Kimi K3.1 Pro: qué cambia, cuánto cuesta y qué dicen los benchmarks
En este artículo
Moonshot AI presentó Kimi K3.1 Pro el 23 de octubre de 2026, el primer modelo de su nueva serie K3.1, con una ventana de contexto de un millón de tokens. Hoy se puede usar desde Kimi.ai, Kimi Work, Kimi Code y la API. Los pesos completos todavía no: la empresa dice que se publicarán hasta el 4 de noviembre.
Mi lectura corta: K3.1 Pro es una opción seria para probar, con un precio de lista bajo frente a los modelos de frontera que cubrí en este blog. Pero casi todo lo que sabemos de su rendimiento lo publica la propia Moonshot, y un precio por token bajo no te dice cuánto cuesta terminar una tarea. Antes de moverle tráfico real, conviene medirlo con trabajo propio.
Me apoyo en el anuncio oficial, la documentación de la API y la página de precios, consultados el 23 de octubre de 2026. No es un benchmark propio: los resultados son declaraciones del fabricante y los atribuyo como tales.
Qué hay disponible hoy y qué todavía no
| Dato | Kimi K3.1 Pro (según Moonshot AI) |
|---|---|
| Lanzamiento | 23 de octubre de 2026 |
| Dónde se usa | Kimi.ai, Kimi Work, Kimi Code y Kimi API |
| IDs en la API | kimi-k3.1-pro y kimi-k3.1-pro-highspeed |
| Contexto | 1 millón de tokens (1.048.576) |
| Pesos | No publicados. Anuncio: «hasta el 4 de noviembre» |
| Licencia | No observada en las páginas consultadas |
| Empresas | Los administradores de Kimi Enterprise deben habilitarlo; viene apagado por defecto |
Moonshot lo llama modelo de «pesos abiertos» (open-weight), pero eso es una intención hasta que los pesos estén publicados y haya una licencia que leer. Hasta entonces no lo llamaría open source ni daría por hecho que podés alojarlo vos. También según la empresa, es una versión posentrenada de Kimi K3 con mucho más cómputo de posentrenamiento, no un modelo nuevo desde cero. Lo describe como de «clase 3T»; no verifiqué la cifra exacta de parámetros para esta versión, así que no la uso.
Sale también Kimi K3.1 Pro Highspeed, que según Moonshot ofrece entre 2 y 3 veces la velocidad: afirmación del fabricante que no medí. Y en la API, el modelo se desbloquea tras una recarga exitosa de, como mínimo, US$1, que además define el nivel y los límites de tu cuenta.
El contexto de 1M: qué significa y qué no garantiza
Un millón de tokens es la capacidad máxima de la ventana: sirve cuando el material de entrada es grande (repositorios, expedientes, conjuntos de PDF). La documentación da tres cifras que importan al diseñar una prueba:
max_completion_tokensviene por defecto en 131.072 y se puede subir hasta 1.048.576.- El modelo siempre razona: según la documentación, no se puede apagar el pensamiento. Lo único que se puede hacer es bajar el esfuerzo (
reasoning_effort:low,highomax). - El valor por defecto del esfuerzo es
max.
Lo último pesa: si no tocás nada, cada llamada corre al esfuerzo máximo, con el consumo de tokens y el tiempo que eso implique. Y la ventana grande es una capacidad, no una promesa de calidad: el anuncio no mide cuánto aprovecha el modelo un prompt de 800.000 tokens, y llenarla cuesta dinero y latencia. Si tu caso depende del contexto largo, medilo primero con tus propios documentos.
El precio: dos modelos, una tabla
La página oficial de precios publica, en dólares por millón de tokens (MTok, sin impuestos), esta tabla para los modelos de la serie K3. Transcribo las filas tal como figuran:
| Modelo | Entrada | Salida | Entrada cacheada | Escritura de caché (5 min) | Escritura de caché (1 h) |
|---|---|---|---|---|---|
kimi-k3.1-pro | US$2,00 | US$10,00 | US$0,20 | US$2,00 | US$4,00 |
kimi-k3.1-pro-highspeed | US$4,00 | US$20,00 | US$0,20 | US$4,00 | US$8,00 |
kimi-k3 (referencia) | US$3,00 | US$15,00 | US$0,30 | US$3,00 | US$6,00 |
Fuente: precios de inferencia de la API de Kimi, acceso 23 de octubre de 2026.
K3.1 Pro es, en lista, más barato que su predecesor K3. Y la documentación indica que no hay escalones de precio por longitud de contexto: los dos niveles de escritura de caché (5 minutos y 1 hora) son escalones de duración, no de tamaño de prompt. A diferencia de otros modelos que cubrí, no hay una franja cara que se active al pasar cierto umbral. El caché se aplica solo a prefijos repetidos, con un TTL por defecto de 5 minutos.
Contra otros modelos, solo con lo que ya publiqué
Para ubicar el precio, uso únicamente las cifras de lista que figuran en mis análisis anteriores; no consulté de nuevo esas páginas hoy:
- Claude Opus 5.5: US$4 de entrada y US$20 de salida por millón de tokens.
- GPT-6 Astra: US$10 de entrada y US$50 de salida, con tarifas mayores en prompts largos.
Contra esas cifras, K3.1 Pro cuesta la mitad que Opus 5.5 y una quinta parte que Astra en precio de lista por token. Es aritmética sobre tarifas: no dice nada de calidad ni de costo por tarea, y esas notas tienen fecha, así que revisá las tarifas vigentes.
Precio por token no es costo por tarea
El costo que pagás es el precio por token multiplicado por los tokens que la tarea necesita, más lo que cuesta cada intento fallido, cada llamada a herramientas y cada revisión humana. Un modelo barato que necesita tres intentos puede salir más caro que uno caro que acierta a la primera. Ese mecanismo ya apareció medido en el análisis de Gemini 3.8 Flash.
En K3.1 Pro hay tres razones concretas para no cerrar la cuenta con la tabla:
- Siempre razona y el esfuerzo por defecto es el máximo. Más razonamiento suele significar más tokens generados; la documentación no detalla cómo se contabilizan en la factura, así que miralo en el uso reportado de tu cuenta.
- Los reintentos no vienen en la tabla. Una llamada que falla también se paga.
- Moonshot publicó en X un gráfico de puntaje contra costo por tarea, pero no figura en el artículo oficial. No lo reproduzco ni cito sus números: no tengo el archivo oficial ni una fuente verificable de esos costos.
El único dato oficial de costo es la tabla de precios. Cuánto te cuesta a vos se mide.
Los benchmarks: qué publicó Moonshot y cómo leerlo
Moonshot AI publicó una comparación oficial de 14 evaluaciones con K3.1 Pro frente a Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra, GLM-5.3 y DeepSeek-V4.1-Flash-1017 (no todos figuran en cada fila). La reproduzco sin modificar.
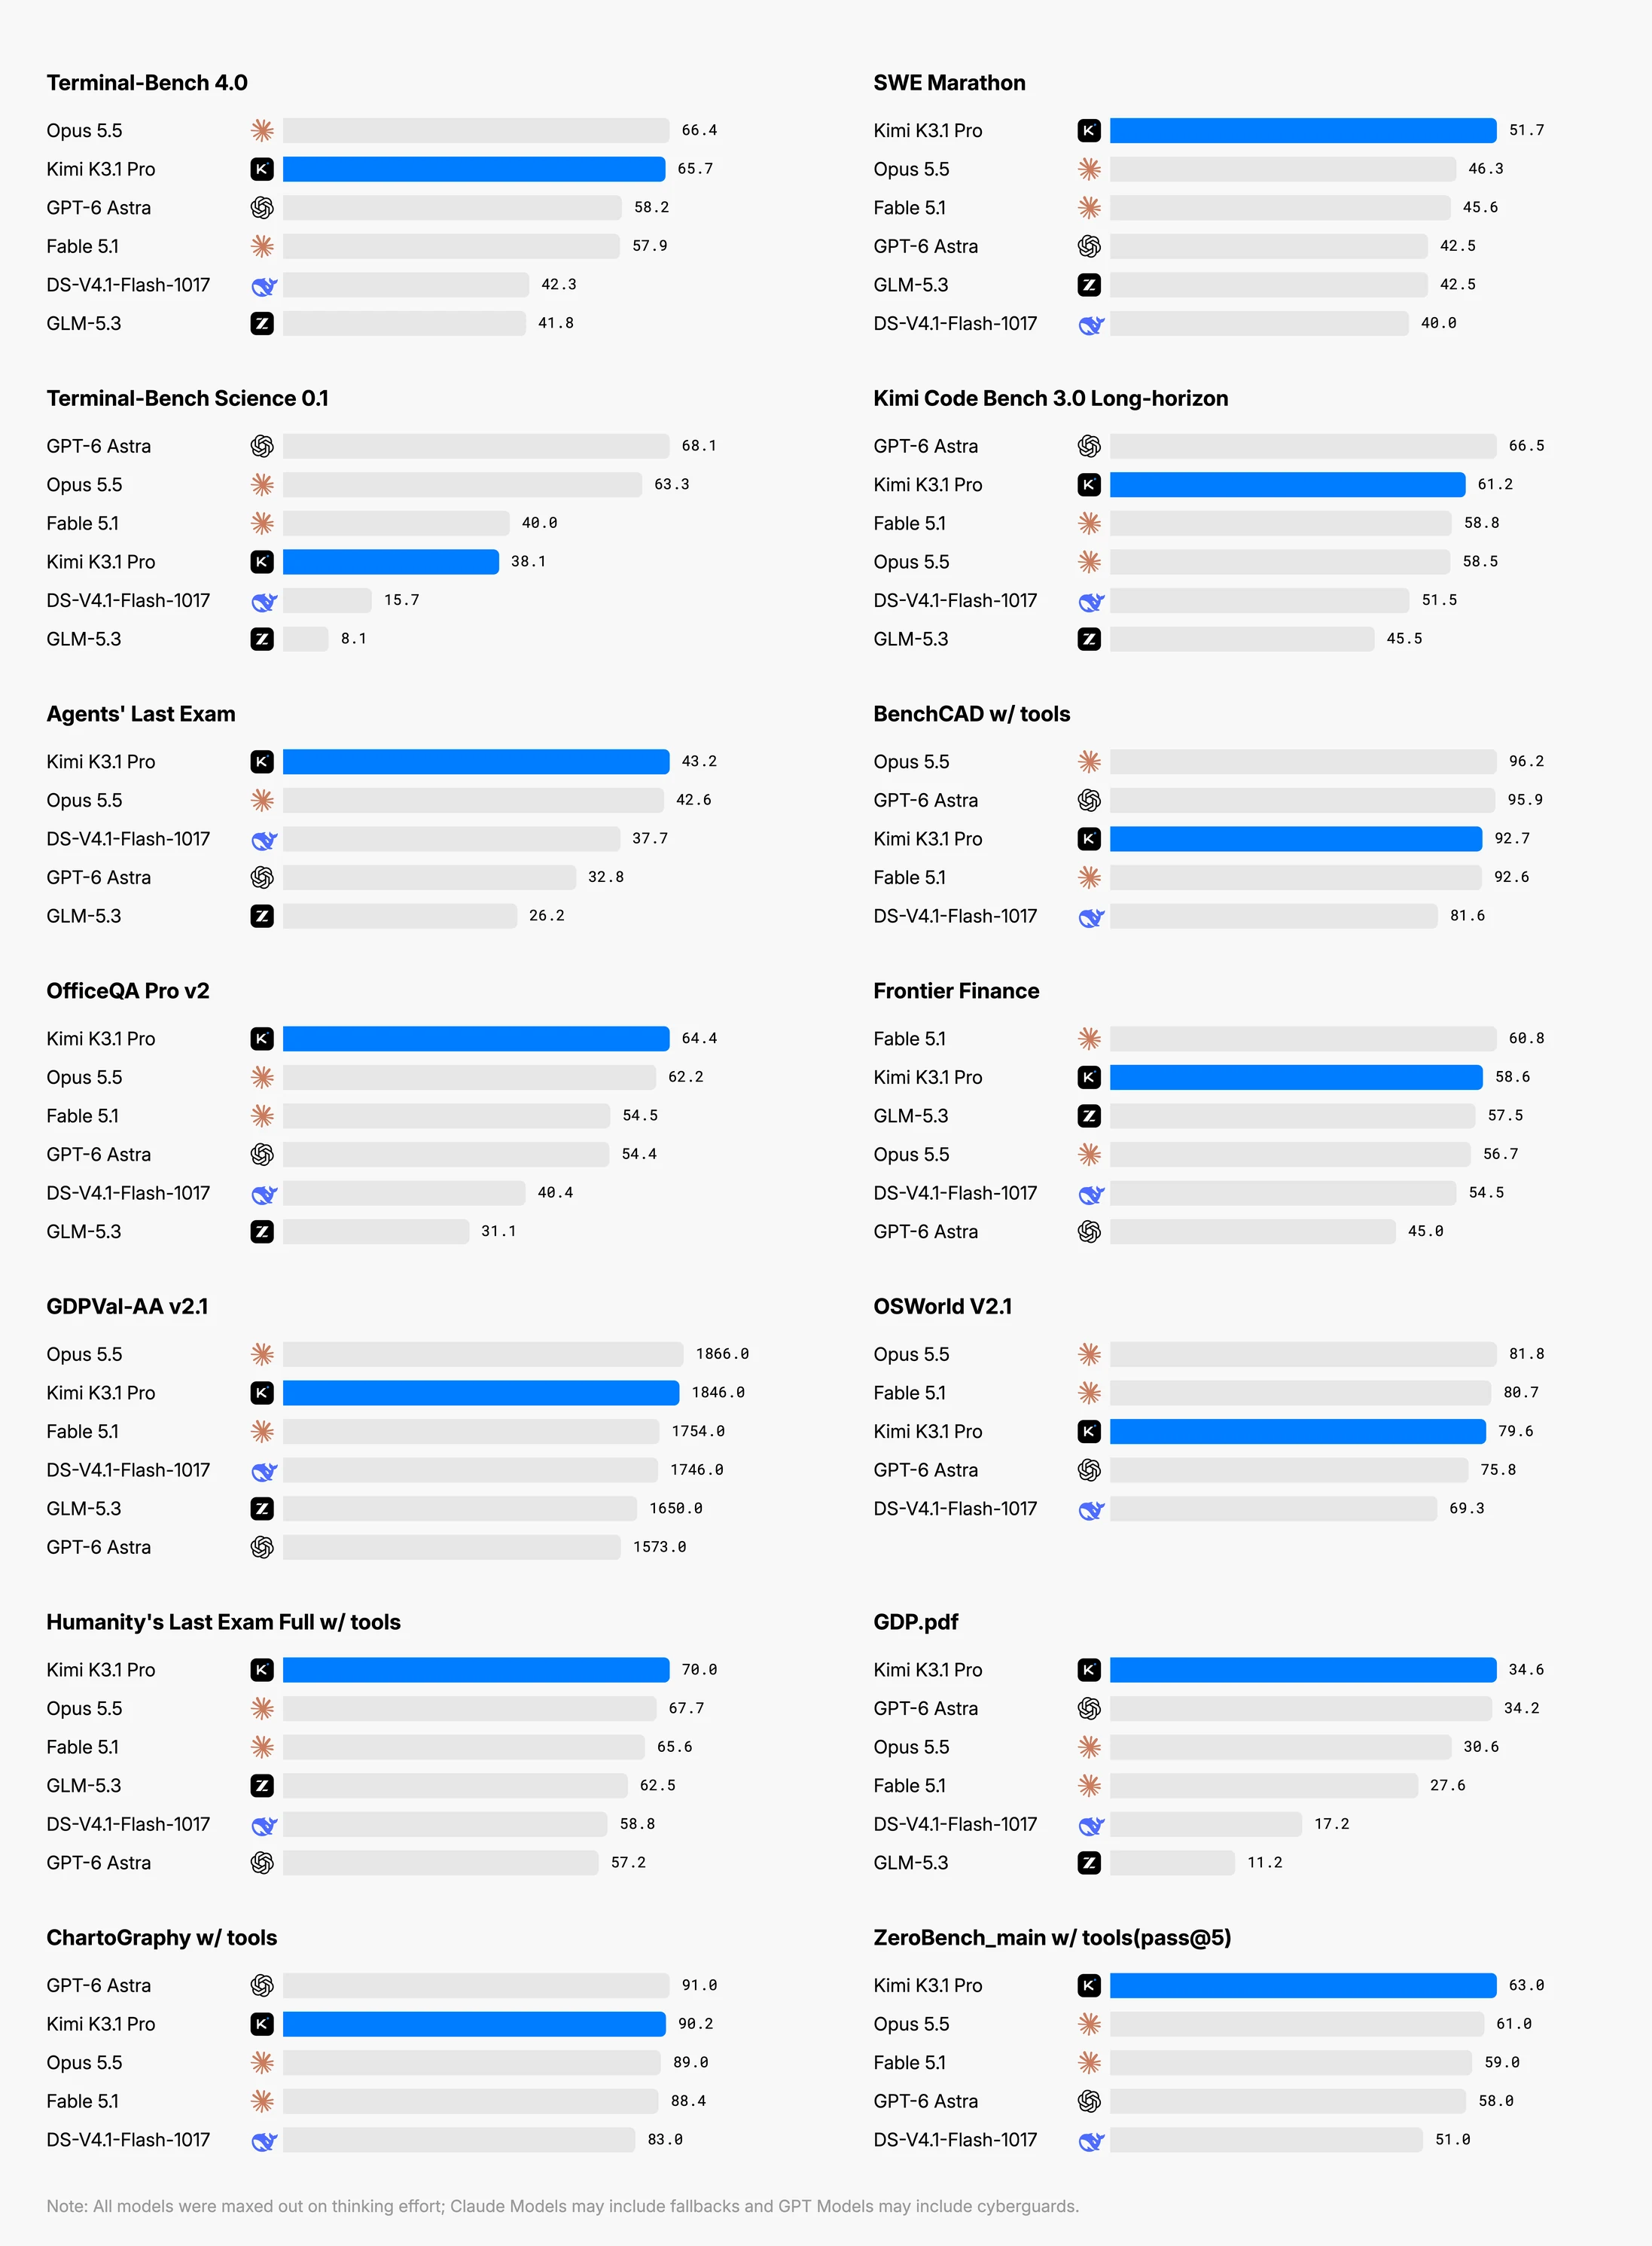
Fuente: anuncio oficial de Kimi K3.1 Pro — Moonshot AI, acceso 23 de octubre de 2026. Imagen oficial rehosteada sin modificaciones. Todos los valores son del fabricante; mostrarlos no los valida. La nota de la propia imagen dice: «Todos los modelos se llevaron al máximo esfuerzo de razonamiento; los modelos de Claude pueden incluir fallbacks y los de GPT pueden incluir cyberguards».
En mi conteo sobre el gráfico, K3.1 Pro lidera 6 de las 14 evaluaciones y queda segundo, tercero o cuarto en las otras 8. Moonshot afirma que «iguala o se acerca» a los modelos propietarios más fuertes: el gráfico es coherente con eso, no con una victoria general. Y hay distancias grandes, como en Terminal-Bench Science 0.1 (38,1 contra 63,3 de Opus 5.5 y 68,1 de GPT-6 Astra).
Ver la transcripción de K3.1 Pro, Opus 5.5 y GPT-6 Astra
Transcribo solo tres de los seis modelos del gráfico, leídos a mano de la imagen; si hay una diferencia, vale la imagen oficial. Las filas conservan el orden y los rótulos del original.
| Evaluación | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 | 66,4 | 58,2 |
| SWE Marathon | 51,7 | 46,3 | 42,5 |
| Terminal-Bench Science 0.1 | 38,1 | 63,3 | 68,1 |
| Kimi Code Bench 3.0 Long-horizon | 61,2 | 58,5 | 66,5 |
| Agents' Last Exam | 43,2 | 42,6 | 32,8 |
| BenchCAD con herramientas | 92,7 | 96,2 | 95,9 |
| OfficeQA Pro v2 | 64,4 | 62,2 | 54,4 |
| Frontier Finance | 58,6 | 56,7 | 45,0 |
| GDPVal-AA v2.1 | 1846,0 | 1866,0 | 1573,0 |
| OSWorld V2.1 | 79,6 | 81,8 | 75,8 |
| Humanity's Last Exam Full con herramientas | 70,0 | 67,7 | 57,2 |
| GDP.pdf | 34,6 | 30,6 | 34,2 |
| ChartoGraphy con herramientas | 90,2 | 89,0 | 91,0 |
| ZeroBench_main con herramientas (pass@5) | 63,0 | 61,0 | 58,0 |
Por qué 65,7 contra 66,4 no es un ranking
El dato más citable del anuncio: en Terminal-Bench 4.0, K3.1 Pro marca 65,7%, por delante de GPT-6 Astra (58,2%) y 0,7 puntos por detrás de Claude Opus 5.5 (66,4%). Hay que leer la nota al pie: K3.1 Pro se evaluó con el arnés de Claude Code, y los demás puntajes se tomaron, según la nota, «como el valor máximo reportado en sus blogs o en el ranking oficial de Terminal-Bench 4.0».
Es una compilación, no una corrida uniforme: cada puntaje sale de una fuente y un arnés distintos, y elegir el máximo reportado puede favorecer a quien tenga más resultados publicados. Una diferencia de 0,7 puntos entre números de orígenes distintos no es una posición en un ranking. Pasa también en otras filas: en OfficeQA Pro, Astra se evaluó con Codex y los demás con Claude Code.
Tres bloques de evidencia que no se suman
No junto estos resultados en una sola tabla de posiciones porque responden a preguntas distintas.
1. Resultados del vendor, en benchmarks públicos. El gráfico de arriba, más cifras puntuales del texto: 92,7% en BenchCAD con herramientas contra 96,2% de Opus 5.5 y 95,9% de Astra, y 64,4 en OfficeQA Pro v2 contra 62,2 de Opus 5.5. Condiciones: effort máximo y arneses que cambian por modelo.
2. Benchmarks internos de Moonshot. Son pruebas diseñadas y corridas por la empresa:
- Kimi Code Bench 3.0 Long-horizon: 61,2% para K3.1 Pro contra 55,95% de K3: una mejora contra su propio predecesor (el gráfico muestra además a Astra con 66,5).
- Kimi Hallu Bench Hard: la tasa de alucinación a nivel de afirmación bajó de 23,4% (K3) a 8,3%. En el gráfico oficial, en la versión Hard con herramientas, GPT-6 Astra marca 5,5 y Opus 5.5 marca 15,0; en la versión sin herramientas, Astra marca 4,2, K3.1 Pro 5,4 y Opus 5.5 6,8. Moonshot aclara que es una prueba de estrés y que «las tasas no representan tasas de error generales en el uso diario».
- xdev-bench-hard (ciberseguridad): lo trato más abajo.
Un benchmark interno sirve para ver si un modelo mejoró respecto de su versión anterior, no para compararlo con terceros: quien diseña la prueba también decide qué mide.
3. Evidencia de terceros. Solo una pieza, y no pude corroborarla: una publicación de @arena en X sostiene que K3.1 Pro (Max) ocupa el puesto 8 en Code Arena: WebDev, con 1692 puntos, junto a Claude Opus 5 (Max) con 1691. Ese ranking mide preferencias de usuarios en desarrollo web, no calidad general, y arena.ai respondió con error de acceso cuando intenté verlo. Es una señal atribuida, no un dato confirmado.
Seguridad y pesos abiertos, en breve
Moonshot dedica una sección a ciberseguridad. Según la empresa, encontró contenido de ese tipo mezclado en el corpus de entrenamiento intermedio (mid-training) y en sus entornos de aprendizaje por refuerzo, y para la versión de pesos abiertos lo eliminó de ambas etapas. En su benchmark interno xdev-bench-hard, el punto de control sin esas medidas resuelve 90,5% de los problemas (pass@3) y el K3.1 Pro final llega a 81,0%. Dice además que su capacidad ofensiva sigue por detrás de la de los modelos propietarios de frontera.
Es una prueba propia y no valida por sí sola que el modelo sea seguro para tu caso. Si tu equipo piensa alojarlo, la licencia que acompañe a los pesos del 4 de noviembre es lo que hay que leer antes de planificar nada.
Cuándo tiene sentido probarlo
Lo evaluaría si tu trabajo se parece a lo que Moonshot destaca (programación larga con herramientas, documentos financieros o de oficina, muchas entradas) o si el costo por token de tu modelo actual es un problema real. La documentación menciona retención cero de datos (Zero Data Retention) para clientes de la API; no evalué esa opción.
No lo adoptaría solo por el gráfico. Elegir modelo es una decisión dentro de las piezas que lo rodean: qué modelo para cada tarea, cómo verificás su salida y cómo observás lo que gasta. Un modelo nuevo es una hipótesis hasta que lo medís con tus casos.
Protocolo de prueba, en seis pasos
- Elegí una tarea real y acotada, con un resultado que puedas verificar.
- Escribí los criterios de aceptación antes de correr nada: qué cuenta como correcto.
- Usá el mismo prompt y las mismas herramientas en K3.1 Pro y en el modelo que usás hoy. Fijá el esfuerzo (
reasoning_effort) a propósito, porque el valor por defecto de K3.1 Pro esmax. - Registrá errores, tiempo y tokens de cada corrida, y repetí varias veces: una sola corrida no alcanza.
- Sumá el costo total: tokens de entrada y salida, reintentos, llamadas a herramientas y minutos de revisión humana.
- Decidí con tu tabla, no con la de Moonshot: costo por tarea aceptada, no precio por millón.
Si querés una segunda mirada para diseñar esa prueba, la página de contacto es el canal directo.
Preguntas frecuentes
¿Kimi K3.1 Pro es open source?
Todavía no se puede afirmar. Moonshot AI lo describe como un modelo de pesos abiertos (open-weight), pero dice que los pesos completos se publicarán hasta el 4 de noviembre de 2026: hoy no están disponibles. Tampoco observé una licencia publicada, así que no corresponde llamarlo open source.
¿Cuánto cuesta Kimi K3.1 Pro en la API?
US$2 por millón de tokens de entrada y US$10 de salida; la entrada cacheada cuesta US$0,20. La variante Highspeed cuesta US$4 y US$20. La página oficial indica que no hay escalones de precio por longitud de contexto; los escalones de escritura de caché son por duración (5 minutos o 1 hora), no por tamaño de prompt.
¿El contexto de 1 millón de tokens garantiza que el modelo use bien todo el prompt?
No. Es la capacidad máxima de ventana: la ficha oficial indica 1.048.576 tokens. No mide cuánto del texto el modelo aprovecha bien, ni qué pasa con la latencia o el costo cuando llenás esa ventana. Eso se mide con tus propios documentos.
¿Kimi K3.1 Pro le gana a Claude Opus 5.5 o a GPT-6 Astra?
Depende de la fila y no hay un ranking único confiable. En el gráfico oficial de Moonshot, K3.1 Pro lidera 6 de 14 evaluaciones y queda detrás en otras. En Terminal-Bench 4.0 marca 65,7% contra 66,4% de Opus 5.5, pero los puntajes de los otros modelos se tomaron de distintas fuentes y arneses, así que no es una comparación manzana con manzana.
¿Cómo conviene probarlo antes de adoptarlo?
Con una tarea real tuya, el mismo prompt en cada modelo, criterios de aceptación escritos antes y registro de errores, tiempo y costo total, incluidos reintentos y revisión humana. Y con el effort fijado, porque el valor por defecto de K3.1 Pro es el máximo.
Fuentes consultadas
- Introducing Kimi K3.1 Pro — Moonshot AI (disponibilidad, pesos, benchmarks del vendor, notas al pie, ciberseguridad). Acceso: 23 de octubre de 2026.
- Precios de inferencia de la API de Kimi — Kimi API Platform (tabla de precios, contexto, caché). Acceso: 23 de octubre de 2026.
- Guía de inicio de Kimi K3.1 Pro — Kimi API Platform (esfuerzo de razonamiento, límites, requisitos de acceso, facturación). Acceso: 23 de octubre de 2026.
- Publicación de @arena en X sobre Code Arena: WebDev — vista en una captura aportada; no se pudo recuperar el original ni verificar el ranking.
- Cifras de lista de otros modelos: Claude Opus 5.5 y GPT-6 Astra, según esos análisis y con su fecha.
- Portada y comparación de benchmarks: imágenes oficiales de Moonshot AI rehosteadas sin modificaciones. Fuente: Moonshot AI. La procedencia oficial no es una licencia de reuso.

Especialista en Agentes de IA · Copenhague
Diseño e implemento agentes IA, MCP servers y harnesses en producción: el loop, las herramientas y el contexto que hacen que un modelo pase de contestar a trabajar. Todo lo que ves en este sitio está construido así.