REA: ingeniería inversa con IA, más allá del entusiasmo
En este artículo
REA —Reverse Engineer Anything— conecta un agente de IA con herramientas para investigar aplicaciones, binarios y comportamiento en ejecución. Su aporte no es convertir cualquier programa en código fuente con una pregunta: es permitir que el agente consulte evidencia, siga referencias y contraste hipótesis sobre cómo funciona una parte del software.
El proyecto está circulando en redes con una promesa mucho más amplia: si podés entender una aplicación sin tener su código, ¿cuánto falta para reconstruirla? La pregunta es interesante. Dar por hecho que ya podés copiar cualquier producto, de forma privada y sin restricciones, mezcla capacidades distintas.
Revisé el repositorio, su documentación, un caso publicado y conversaciones públicas. Esta nota es un análisis documental, no una prueba propia de REA ni una auditoría de seguridad. La revisión técnica toma como referencia el código del 20 de octubre de 2026; la última release consultada es 6.7.0, publicada el 18 de octubre. Las funciones de la rama de desarrollo no deben darse por disponibles automáticamente en ese paquete.
Qué es REA y qué cambia frente a pegar código en un chat
La ingeniería inversa parte de un resultado —un ejecutable, un paquete o un comportamiento observable— para investigar cómo fue construido. No siempre busca reconstruir el programa: también sirve para entender una dependencia, diagnosticar un problema, estudiar un formato o trabajar en interoperabilidad.
Un chat al que le pegás pseudocódigo solo ve lo que elegiste copiar. Si le falta saber quién llama a una función, qué valor hay en una dirección o cómo se comunica una ventana con otro proceso, necesita más material.
REA conecta esas consultas con herramientas de análisis. Tiene una interfaz de terminal y un servidor MCP: el mecanismo que permite que un agente invoque herramientas y reciba sus resultados. Si no conocés ese protocolo, podés empezar por la guía de MCP.
El recorrido es: le planteás una pregunta al agente; este consulta REA; REA trabaja sobre el objetivo con sus capacidades o un proveedor de análisis; devuelve observaciones; el agente decide qué revisar después. Una explicación final debería poder volver a esas observaciones, no sostenerse solamente en que el modelo suena convincente.
REA no reemplaza a Ghidra, Hopper o IDA. Puede apoyarse en ellos para el análisis nativo profundo. Tampoco es un modelo nuevo: organiza acceso a herramientas y resultados para que un agente investigue.
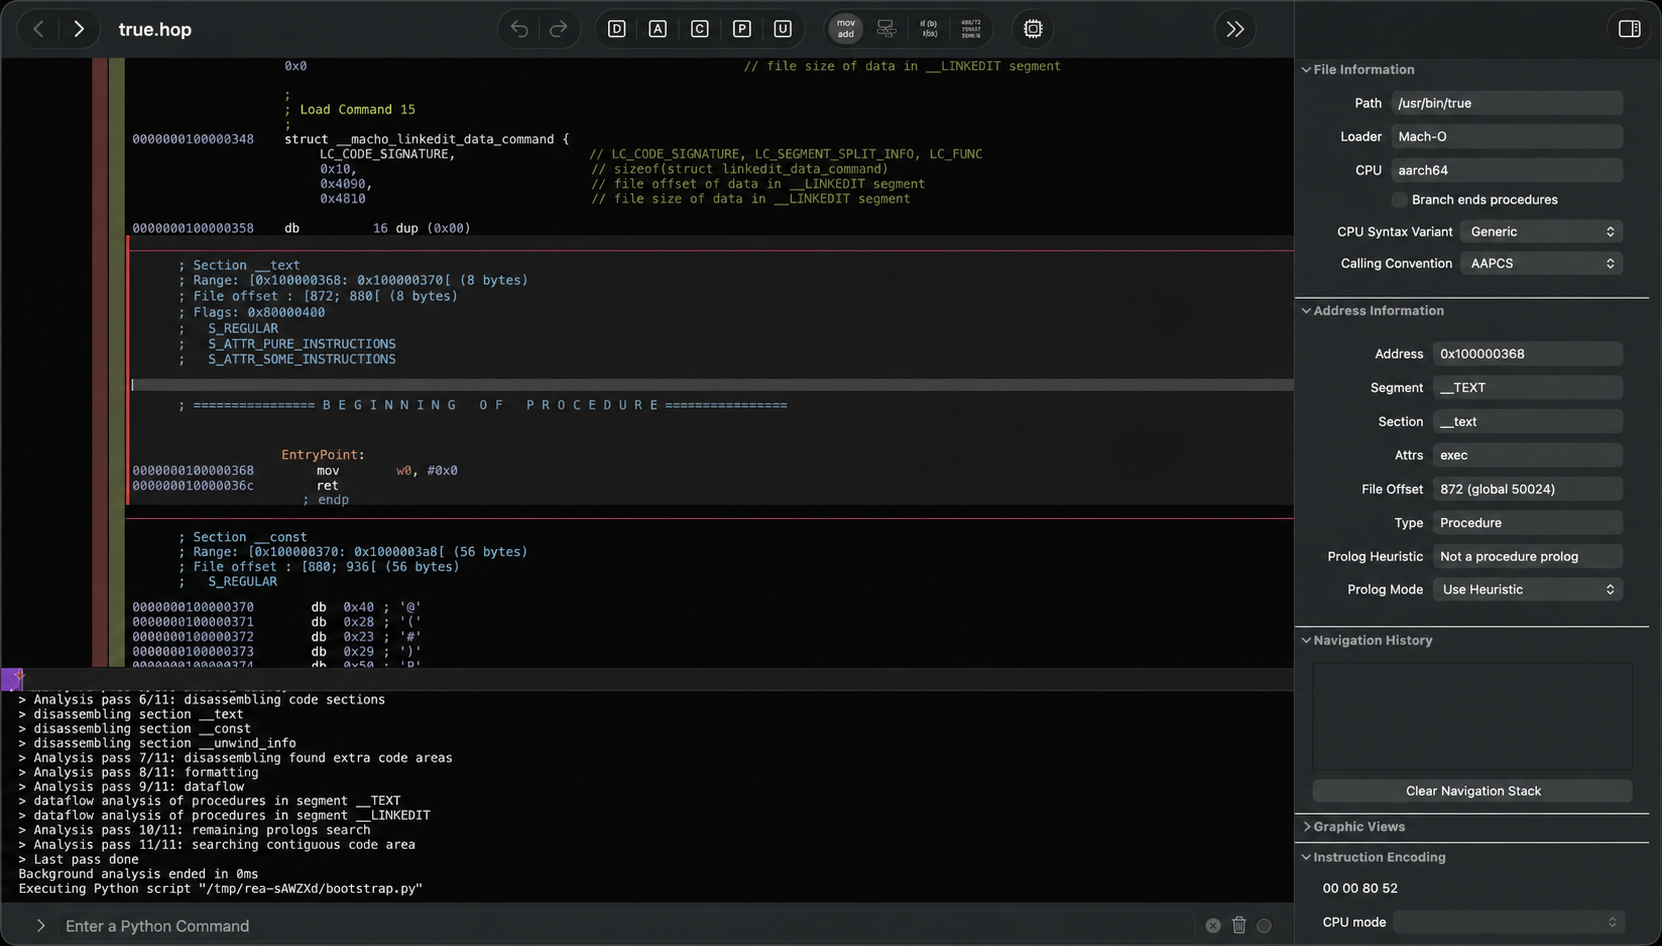
Fuente: README oficial de REA. Captura del proyecto, no de una ejecución realizada para esta nota.
Qué puede investigar y de qué depende
No todos los objetivos requieren las mismas herramientas ni ofrecen la misma profundidad. El inventario oficial distingue, entre otros, estos recorridos:
| Objetivo | Qué documenta REA | Condición importante |
|---|---|---|
| Binarios nativos | Instrucciones, pseudocódigo, símbolos, llamadas y referencias | El alcance depende del proveedor y del formato. |
| JavaScript y Electron | Módulos, imports, source maps y relaciones entre componentes | El análisis estático lee archivos; observar la aplicación en ejecución es otro recorrido. |
| Ensamblados .NET | Metadatos e instrucciones intermedias | La inspección estática no necesita un motor de análisis nativo. |
| Sitios web | Estructura, scripts y observaciones de red | Requiere un navegador compatible y delimitar qué interacciones están autorizadas. |
La lista completa también incluye Android, firmware y otros artefactos, con requisitos específicos. El nombre Reverse Engineer Anything no demuestra que cualquier aplicación sea analizable con el mismo esfuerzo o que todas sus funciones puedan recuperarse.
Para elegir un primer caso, conviene formular una pregunta acotada: «¿qué función calcula este valor?» o «¿cómo pasa este mensaje entre dos componentes?». “Entendé y reconstruí toda esta aplicación” dificulta saber si una respuesta es completa y dónde dejó de haber evidencia.
Qué se está diciendo en redes, y qué podemos sostener
Hay conversación pública verificable sobre REA en los últimos días. Eso no alcanza, por sí solo, para medir una supuesta viralidad semanal ni para tratar los comentarios como pruebas técnicas.
En LinkedIn, una publicación del 14 de octubre presenta la herramienta con expresiones como «Todo localmente. Sin subir nada a internet». Una revisión de DuneTech Labs del 16 de octubre toma otro camino: aclara que no la instaló y señala los límites de privacidad y permisos.
La diferencia importa: ambos son comentarios sobre el mismo proyecto, pero no describen el mismo nivel de certeza. Que REA analice localmente no significa que un agente conectado a un modelo remoto mantenga todos los resultados en tu computadora.
En las discusiones del repositorio aparece una mirada más operativa. Un usuario que reporta una integración con una impresora, el 15 de octubre, aclara que una parte del trabajo —el bytecode de Hermes— requirió otra herramienta. El 19 de octubre, otra discusión pregunta cómo reducir el contexto enviado al modelo y evitar análisis repetidos. Son testimonios útiles para identificar preguntas, no resultados que yo haya reproducido.
También hay un hilo de Hacker News del 10 de octubre. Es parte del contexto de la conversación, pero no corresponde presentarlo como una novedad de esta semana.
Mi lectura es que se están mezclando tres cosas: acceso más cómodo al análisis, reconstrucción de comportamientos concretos y sustitución de productos completos. REA aporta ejemplos de las primeras dos. La tercera exige demostrar mucho más.
El caso de DX-Ball: una función, evidencia y una comprobación
El caso publicado de DX-Ball es más instructivo que una promesa general de “clonar aplicaciones”. La pregunta es concreta: cómo convierte el juego la posición horizontal de un impacto en el paneo del sonido entre izquierda y derecha.
La primera vista del descompilador era incompleta: mostraba una conversión, pero no explicaba la entrada ni el cálculo. La investigación siguió las instrucciones, la función que hacía la llamada y los valores almacenados en el ejecutable. Con ese material se escribió una implementación en C.
La parte valiosa viene después: el caso no termina cuando aparece código plausible. El proyecto publica comparaciones del resultado con la función original y una comprobación del código compilado bajo condiciones específicas. Son verificaciones sobre esa función, no una garantía sobre el juego entero.
Además, la propia página aclara que el trabajo para convertir la reconstrucción en un juego jugable continúa. REA suministra las observaciones; el proyecto de reconstrucción implementa y prueba el resultado.
No ejecuté esas comprobaciones. El caso enlaza código, notas y evidencia para examinarlas; eso lo vuelve más rastreable que una captura con un resultado llamativo, pero no lo convierte en una validación independiente hecha para esta nota.
Tener evidencia no significa haber probado la conclusión
REA documenta un contrato de resultados que conserva información sobre lo observado y sus limitaciones. Es importante porque una respuesta vacía puede tener significados muy distintos.
“No encontré llamadas” no demuestra que una función no haga llamadas si la herramienta no pudo observar todas las relaciones. Del mismo modo, que dos artefactos coincidan estáticamente no demuestra que se comporten igual cuando se ejecutan.
Para evaluar una conclusión, buscaría tres niveles separados:
- Observación: qué instrucciones, datos o relaciones devolvió la herramienta y con qué cobertura.
- Interpretación: qué explicación propone el modelo a partir de ese material.
- Comprobación: qué prueba contrasta la explicación con el comportamiento que importa.
Un identificador de evidencia ayuda a volver al material. No convierte una interpretación en un hecho. Esa separación debería mantenerse incluso cuando el agente produce una explicación clara o una implementación que compila.
Local no significa privado, y un puente autenticado no es un sandbox
Antes de probar REA hay dos fronteras distintas: dónde circula la información y qué puede ejecutar el sistema.
El README dice que REA analiza los objetivos localmente y que el agente recibe los resultados. La política del proveedor del modelo sigue siendo relevante. Si esos resultados contienen código propietario, cadenas sensibles o información de una aplicación interna, “el análisis corre local” no resuelve por sí solo si corresponde compartirlos.
Por otra parte, la política de seguridad es explícita: REA no es un sandbox. Autenticar los puentes y usar directorios privados limita ciertos accesos, pero no convierte el análisis de un binario hostil en una operación segura. El proveedor local procesa ese archivo con los permisos del usuario.
Tampoco es lo mismo leer archivos que ejecutar una aplicación, adjuntarse a un proceso o capturar tráfico. Esas operaciones pueden modificar estado y exponer información. Necesitan su propio alcance y un entorno adecuado, no una autorización genérica para “investigar”. La distinción está desarrollada en la nota sobre límites y permisos para agentes de IA.
Entender una función no te da derechos sobre un producto
La licencia de REA no es la licencia del software que analizás. Poder acceder a un archivo tampoco concede automáticamente permiso para cualquier uso de sus contenidos.
El disclaimer del proyecto enumera usos legítimos como interoperabilidad, preservación, educación y análisis autorizado. También aclara que no apoya copiar código o activos propietarios ni eludir protecciones. Esa posición no modifica la licencia MIT de REA ni reemplaza las obligaciones aplicables al objetivo.
La conclusión comercial también necesita cuidado. Comprender una parte de una aplicación no demuestra haber recuperado su backend, sus datos, su operación ni el valor que ofrece a sus usuarios. La distancia entre reproducir una interacción visible y sostener un producto no desaparece porque el primer paso sea más accesible.
Cómo evaluaría REA sin empezar por la promesa más grande
Empezaría con software propio o expresamente autorizado, una pregunta pequeña y un criterio de éxito que no dependa de la opinión del modelo. Por ejemplo: explicar un cálculo de un programa de prueba y contrastar entradas y salidas con una implementación cuya fuente conozcas.
Antes de conectar el agente, dejaría resuelto qué archivos puede leer, qué resultados puede enviar al proveedor del modelo y si puede ejecutar o interactuar con el objetivo. Después conservaría las observaciones, las hipótesis y las comprobaciones por separado.
También registraría las versiones de REA y del proveedor utilizado. El proyecto cambia rápido, y una capacidad documentada en desarrollo puede no estar en el paquete que instalaste. Para descargarlo, el propio README identifica los canales oficiales: morluto/rea, rea.tools y el paquete rea-agents.
Mi conclusión: REA merece atención por acercar herramientas de ingeniería inversa al recorrido de trabajo de un agente y por hacer explícita la evidencia que devuelve. No hace falta atribuirle la capacidad de copiar cualquier aplicación para que resulte interesante.
Si querés explorar una herramienta así, empezá por decidir qué necesitás entender y cómo comprobarías la respuesta. Una buena explicación es el comienzo de la investigación, no su cierre.
Preguntas frecuentes
¿REA recupera el código fuente original de cualquier aplicación?
No. Puede aportar análisis, pseudocódigo y observaciones para investigar un programa. Una reconstrucción requiere trabajo adicional y pruebas; no garantiza recuperar los nombres, comentarios, estructura o comportamiento completo del original.
¿REA necesita Ghidra, Hopper o IDA?
El análisis nativo profundo utiliza un proveedor como esos. La inspección estática de JavaScript y .NET puede trabajar sin un motor nativo; los requisitos cambian según el formato y la operación.
¿Usar REA significa que los datos nunca salen de mi computadora?
No. REA documenta análisis local, pero el agente recibe sus resultados. Si utiliza un modelo remoto, esos resultados quedan sujetos a la configuración y política de ese proveedor.
Fuentes y alcance de la revisión
Revisión documental al 20 de octubre de 2026, con referencia técnica fijada. Los casos y comentarios enlazados se atribuyen a sus autores; no ejecuté REA ni reproduje sus resultados. Las publicaciones sociales sirven para analizar el debate, no para verificar capacidades.

Especialista en Agentes de IA · Copenhague
Diseño e implemento agentes IA, MCP servers y harnesses en producción: el loop, las herramientas y el contexto que hacen que un modelo pase de contestar a trabajar. Todo lo que ves en este sitio está construido así.