Gemini 4 Argon: qué cambia, cuánto cuesta y cuándo probarlo
En este artículo
Gemini 4 Argon es el nuevo modelo de Google para problemas que requieren sostener el razonamiento durante mucho tiempo: ingeniería de software, investigación y trabajo especializado con múltiples pasos. Su novedad no es solamente una tabla de resultados: también cambia cuánto puede generar y cómo hay que administrar el presupuesto de una ejecución.
Mi lectura: vale la pena evaluarlo cuando una tarea compleja se corta, pierde continuidad o exige demasiadas intervenciones con el modelo actual. No hay evidencia suficiente para recomendar reemplazar automáticamente todo el stack.
Este análisis se basa en el anuncio, la documentación y las evaluaciones publicadas por Google, consultadas el 14 de octubre de 2026. No es un benchmark propio ni una prueba de uso en producción. Los precios y el acceso pueden cambiar.
Qué es Gemini 4 Argon y qué cambia
Google presentó Argon el 30 de septiembre de 2026, con un despliegue inicial para defensores de ciberseguridad y evaluadores de confianza. Posteriormente anunció su disponibilidad para desarrolladores. No conviene confundir esas dos etapas y describirlo hoy como un modelo exclusivamente restringido a ese grupo inicial.
La ficha técnica vigente documenta entrada de texto, imágenes, video, audio y PDF, con salida de texto. También contempla herramientas, llamadas a funciones y respuestas estructuradas. No es, en esa ficha, un generador de imágenes o audio ni un modelo para Live API.
La apuesta central es la continuidad: resolver un problema que necesita leer información, elaborar una estrategia, probarla y corregirla, en lugar de limitarse a una respuesta breve. Google muestra casos internos de migraciones y optimización de código; son ejemplos del proveedor, no una promesa sobre lo que tu equipo va a conseguir.
Para una empresa, la pregunta útil es concreta: ¿qué tarea no está resolviendo bien el sistema actual y qué resultado tendría que mejorar Argon? Un cambio de modelo sin esa referencia puede agregar gasto sin demostrar valor.
Un millón de tokens: contexto y salida no se suman
Argon tiene una ventana unificada de 1.048.576 tokens. La entrada, el razonamiento interno y la salida consumen el mismo presupuesto. No dispone de un millón para leer y de otro millón independiente para responder.
La distinción importa porque el anuncio destaca la expansión del límite de salida desde 64K hasta 1M. La documentación de implementación agrega las condiciones:
| Concepto | Límite documentado | Implicación práctica |
|---|---|---|
| Ventana unificada | 1.048.576 tokens | Entrada, razonamiento y salida comparten espacio. |
| Salida síncrona por defecto | 65.536 tokens | Una llamada normal no equivale a una generación de un millón. |
| Long decode | Hasta el presupuesto disponible de la ventana | Requiere seguir el flujo de ejecución indicado por Google. |
| Entrada multimodal | Texto, imagen, video, audio y PDF | La salida documentada sigue siendo texto. |
Fuente: ficha de Argon y guía de cambios.
Pensá en un análisis de documentos: cuanto más material cargás y más razonamiento necesita la tarea, menos margen queda para producir una respuesta extensa. Tener una ventana grande tampoco prueba que el modelo vaya a recuperar correctamente cada dato.
Por eso, long decode no reemplaza la selección de contexto. Antes de ampliar una ejecución conviene decidir qué documentos son necesarios, qué evidencia debe citar y dónde puede detenerse para que una persona revise el trabajo.
Qué muestran los benchmarks oficiales de Argon
Google reporta resultados fuertes en trabajo especializado y algunas tareas de programación. Su tabla también muestra áreas donde otros modelos obtienen mejores puntuaciones. Las dos cosas forman parte de la evidencia.
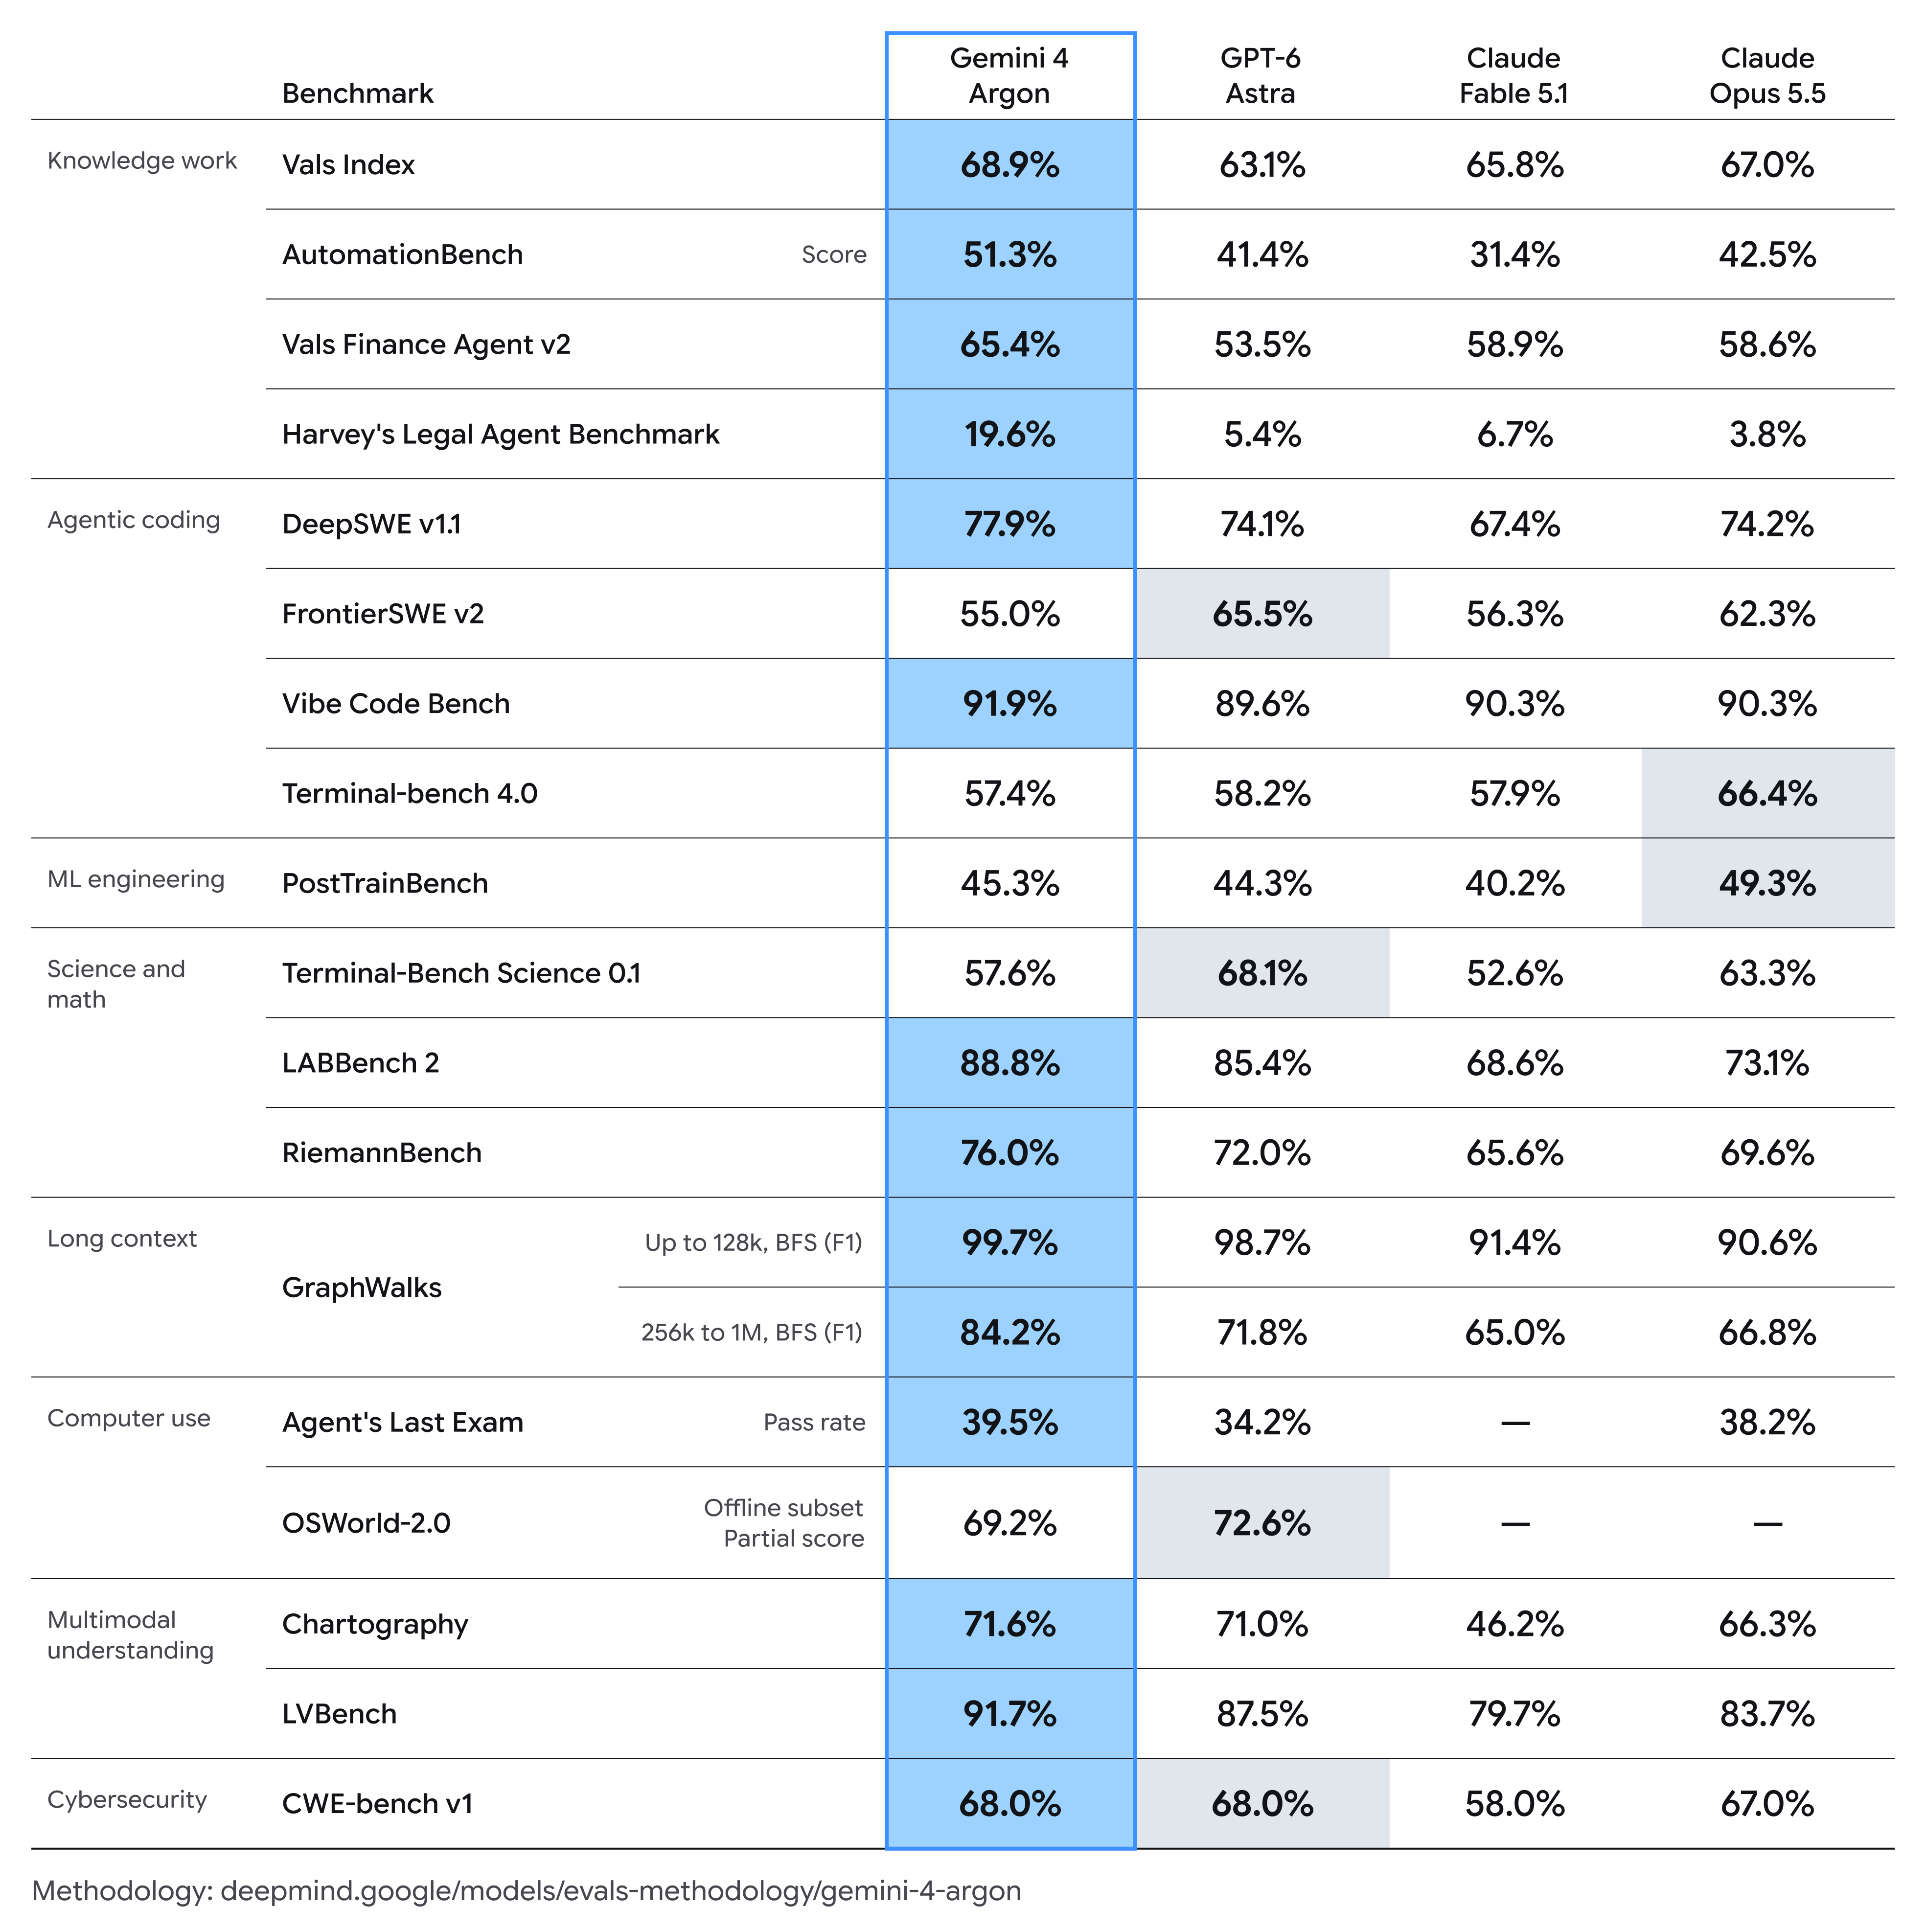
Fuente: anuncio oficial de Google. Imagen original completa, sin redibujar ni modificar sus datos. Abrila para leer los detalles. Reproducir la tabla no valida independientemente sus resultados.
Esta selección transcribe algunas filas para facilitar su lectura; no sustituye la comparación completa:
| Evaluación | Argon | Qué permite observar |
|---|---|---|
| DeepSWE v1.1 | 77,9% | Resultado destacado en ingeniería de software de horizonte largo. |
| AutomationBench | 51,3% | Puntuación mayor que los comparadores presentes en esta tabla. |
| Vals Index | 68,9% | Resultado en un índice de trabajo especializado, no de toda utilidad posible. |
| FrontierSWE v2 | 55,0% | GPT-6 Astra figura con 65,5% en la misma tabla. |
| Terminal-bench 4.0 | 57,4% | Claude Opus 5.5 figura con 66,4%. |
No alcanza con contar las celdas ganadoras. La metodología de Google distingue sus propias ejecuciones de resultados publicados por competidores y otros evaluadores. En DeepSWE describe el uso de mini-swe-agent para Argon; eso no convierte todos los resultados externos en una prueba con idénticas herramientas y condiciones.
En las tareas donde un modelo usa un entorno de ejecución, las herramientas, las instrucciones y el criterio de aprobación también influyen. El resultado corresponde al sistema evaluado, no a una capacidad aislada que puedas trasladar sin cambios a cualquier integración.
Vals Index, además, pondera sectores por su contribución a la economía estadounidense. Es información relevante para ciertos tipos de trabajo, pero no una medida universal de la utilidad del modelo para una pyme, un equipo argentino o un proceso particular.
La conclusión defendible es acotada: Argon merece una evaluación en tareas parecidas a las que muestran sus fortalezas; los rankings no prueban que sea la mejor opción para todo.
Cuánto cuesta Gemini 4 Argon
La guía vigente de Google anuncia precios introductorios hasta el 30 de noviembre de 2026. A partir del 1 de diciembre, las tarifas de entrada y salida indicadas se duplican.
| Tarifa por millón de tokens | Hasta el 30/11/2026 | Desde el 01/12/2026 |
|---|---|---|
| Entrada | US$2 | US$4 |
| Salida | US$10 | US$20 |
Google aclara que los tokens de razonamiento se facturan como salida. La caché y otras modalidades requieren consultar sus condiciones específicas en la página de precios; esta tabla no es una cotización completa de herramientas, descuentos ni infraestructura.
Una respuesta más larga no es gratis porque no se vea todo el razonamiento. Para estimar una tarea necesitás observar el consumo facturado, las llamadas a herramientas, los reintentos y el tiempo de revisión humana.
El criterio que usaría es costo por resultado aceptado, no solamente precio por token. Si querés profundizar ese enfoque, lo desarrollo en el análisis de Gemini 3.8 Flash y el costo por tarea. Que un modelo tenga una tarifa mayor no prueba que resulte más caro por trabajo resuelto; tampoco demuestra lo contrario.
Cómo acceder y qué revisar antes de migrar
Google documenta Argon mediante la Gemini API y Google AI Studio. La guía consultada indica que no está disponible en Free tier ni en Google AI Pro. El anuncio para desarrolladores también menciona Android Studio y Antigravity, con condiciones de acceso asociadas a sus productos y planes. No asumas que una suscripción personal habilita cualquier modalidad de API.
Antes de reemplazar el modelo actual revisaría tres puntos de la guía de migración:
- Razonamiento configurable: niveles
low,mediumyhigh;mediumes el predeterminado documentado. Más esfuerzo no debería convertirse en una configuración automática para toda tarea. - Caché: la ficha indica soporte implícito, pero no caché explícita. Un flujo que depende de esa función necesita revisión, no solo cambiar el identificador a
gemini-4-argon. - Ejecuciones largas: comprobar límites de salida, interrupción y manejo de la ejecución prolongada.
max_output_tokenslimita conjuntamente razonamiento y salida; el presupuesto puede agotarse antes de completar la respuesta visible. Para long decode, Google documenta ejecución en segundo plano o continuaciones del lado del cliente. Una integración diseñada para respuestas cortas puede no soportar ese recorrido.
Hay otra separación necesaria: el modelo puede decidir llamar a una herramienta, pero tu aplicación debe controlar qué herramientas existen, qué datos reciben y qué acciones requieren autorización. La capacidad no define el permiso.
Seguridad: más capacidad exige límites explícitos
Google dedica parte del anuncio a ciberseguridad defensiva, resistencia a inyección de instrucciones y monitoreo de comportamientos fuera de los objetivos del usuario. También publica una model card y un informe de seguridad.
Eso permite revisar lo que el proveedor evaluó. No garantiza que una integración concreta sea segura ni vuelve confiable cualquier documento que el modelo lea. Tampoco habilita por sí mismo a darle acceso a información sensible o acciones irreversibles.
Para un piloto, elegiría datos no sensibles, herramientas de alcance limitado y aprobación humana antes de escribir en un sistema real. Si el objetivo es programación, una copia aislada del repositorio con pruebas proporciona un resultado verificable sin conceder permisos de despliegue.
Cuándo probar Argon y cuándo seguir con el modelo actual
Lo probaría si el problema aparece en tareas extensas: una migración acotada, una investigación con documentos o una modificación que exige varios ciclos de verificación. Primero definiría el resultado correcto y qué errores descalifican una ejecución.
No migraría todavía si el sistema actual cumple el objetivo, el costo está controlado y la única razón del cambio es una posición en un ranking. Para clasificación, extracción simple o respuestas breves, este lanzamiento no demuestra por sí solo una mejora que justifique el reemplazo.
Un piloto útil conserva la misma tarea, contexto, herramientas y criterio de aceptación para el modelo actual y Argon. Registrá si resolvió el problema, cuánto consumió y cuánto trabajo dejó para una persona. Una demostración favorable sirve para explorar; no alcanza para concluir que ya es confiable.
Mi veredicto es de adopción, no de campeonato: Argon amplía opciones para trabajo complejo, pero su valor aparece cuando mejora un resultado verificable bajo un presupuesto y límites que puedas sostener.
Preguntas frecuentes
¿Argon reemplaza a Gemini Flash?
No automáticamente. Elegir un modelo de frontera y uno orientado a otras prioridades requiere comparar la tarea, la latencia, el costo y la calidad aceptada. Este lanzamiento no prueba que todo flujo de Flash deba migrar.
¿Puedo generar un millón de tokens en una llamada normal?
La salida síncrona por defecto documentada es de 65.536 tokens. Long decode tiene su propio flujo, y entrada, razonamiento y salida comparten la ventana unificada. No hay un millón adicional reservado para la respuesta.
¿Estos resultados provienen de pruebas de Nicolás?
No. Son resultados y documentación de Google, acompañados de una lectura crítica de sus condiciones. El criterio de piloto es una recomendación, no un experimento ya ejecutado.
Fuentes y alcance
Información consultada el 14/10/2026. Las tablas de rendimiento pertenecen al proveedor; precios, disponibilidad y condiciones deben revalidarse antes de contratar.

Especialista en Agentes de IA · Copenhague
Diseño e implemento agentes IA, MCP servers y harnesses en producción: el loop, las herramientas y el contexto que hacen que un modelo pase de contestar a trabajar. Todo lo que ves en este sitio está construido así.
Artículos relacionados
Claude Buddy: Guía Completa del Tamagotchi de Claude Code (18 Especies y Rarezas)
Claude Buddy: las 18 especies, 5 rarezas, comandos /buddy y cómo conseguir un Shiny Legendary (0.01% de probabilidad). Guía completa en español.
Muse Wonder de Meta: qué ofrece, cómo rankea y qué revisar
Muse Wonder y Wonder Full: benchmarks oficiales, memoria, tareas largas, acceso, precios y privacidad antes de adoptar los nuevos modelos de Meta.
Antes de darle una tarea a una IA, decidí qué no puede hacer
Cómo definir límites y permisos para una IA: qué puede preparar, qué requiere tu aprobación y qué conviene dejar fuera de su alcance.