Muse Wonder de Meta: qué ofrece, cómo rankea y qué revisar
En este artículo
Muse Wonder es la nueva familia de modelos de Meta para trabajo complejo y agentes que necesitan sostener una tarea durante varios pasos. Hay dos variantes, Wonder y Wonder Full, y no tienen el mismo acceso: el modelo que ves encabezando una tabla puede no ser el que podés integrar por API.
Sí, Meta reporta buenos resultados en algunas evaluaciones. Pero la decisión interesante no es declarar un nuevo ganador: es entender qué aportan su memoria y continuidad, qué variante podés usar y bajo qué condiciones vas a enviar tus datos.
Este análisis utiliza fuentes primarias consultadas el 14 de octubre de 2026. No probé estos modelos en un benchmark propio ni los presento como validados en producción. Distingo las capacidades que anuncia Meta de las conclusiones que esas publicaciones permiten sostener.
Qué es Muse Wonder y en qué se diferencia de Wonder Full
Meta presentó Muse Wonder y Muse Wonder Full como modelos orientados a tareas personales y profesionales: programación, análisis de documentación y trabajo especializado que requiere mantener un objetivo a lo largo de varias acciones.
La documentación de modelos describe para Wonder una ventana de 1.048.576 tokens, entrada de texto, imágenes, video, audio y PDF, y salida de texto. También enumera herramientas, respuestas estructuradas y uso de computadora.
Lo primero que conviene resolver no es cuánto razonamiento activar, sino qué variante está realmente disponible en el producto que vas a usar:
| Variante | Meta Model API | Muse Code |
|---|---|---|
Muse Wonder, muse-wonder-1.0 | Disponible en Standard mode | Pago por uso y planes de suscripción. |
| Muse Wonder Full | No disponible según la documentación consultada | Planes Power Usage y Maximum Usage. |
Activar el esfuerzo de razonamiento max en Wonder no lo convierte en Wonder Full. Meta lo aclara expresamente. Usar los resultados de Full para prometer la calidad del modelo accesible por API sería mezclar dos productos.
Tampoco hay que equiparar el anuncio de un despliegue futuro en Muse con disponibilidad universal en todas las experiencias de Meta. La página de producto, el plan y la región siguen siendo parte de la comprobación antes de contratar.
Active Memory: recordar contexto no es recordar todo bien
Meta llama Active Memory a conservar información relevante entre conversaciones y recuperarla cuando una tarea la necesita. La idea es reducir la necesidad de explicar nuevamente preferencias y antecedentes cada vez que pedís algo.
Un ejemplo hipotético: le compartís a un asistente las restricciones de un proyecto y, días después, le pedís revisar una propuesta relacionada. La utilidad no sería que repita toda la conversación anterior, sino que traiga las restricciones correctas y detecte si la propuesta las contradice.
Ese ejemplo ilustra el concepto; no es una prueba ejecutada con Muse Wonder. Hay varias condiciones que la promesa de memoria no resuelve por sí sola:
- Qué información se almacena y durante cuánto tiempo.
- Cómo se corrige un dato desactualizado.
- Qué fuente respalda un recuerdo y cómo se muestra esa evidencia.
- Quién puede consultar o eliminar la información.
- Qué parte de esa experiencia existe en la aplicación y cuál tenés que implementar en tu integración.
Un modelo disponible por API no te entrega automáticamente toda la experiencia de memoria persistente de un producto. Antes de diseñar alrededor de Active Memory, hay que comprobar el comportamiento documentado de la superficie elegida.
La model card de Meta describe MemoryBench como una evaluación interna con conversaciones extensas. Es evidencia sobre ese ensayo, no una garantía de memoria infalible durante meses ni de que recuerde todo el contexto de un cliente correctamente.
Active Focus: continuidad con un objetivo, no autonomía sin límites
Active Focus es el nombre que Meta da a sostener el esfuerzo ante una tarea difícil: probar otro enfoque, recuperarse de errores y pedir aclaraciones o confirmaciones cuando corresponde. La descripción está en su publicación de investigación.
Para visualizarlo, pensá en una modificación de software que falla una prueba. Un sistema útil no debería limitarse a repetir el mismo cambio: tendría que interpretar el error, revisar su hipótesis y volver a verificar. También debería reconocer cuándo no tiene información suficiente y detenerse.
Persistir no siempre es bueno. Si el objetivo está mal definido, el contexto contiene una instrucción engañosa o los permisos son demasiado amplios, un agente que sigue trabajando puede ampliar el daño.
Por eso separaría dos cuestiones: la capacidad del modelo para continuar y la autoridad del sistema para actuar. Decir que fue entrenado para consultar antes de acciones importantes no sustituye una confirmación obligatoria implementada por la aplicación.
Un piloto tiene que incluir límites de tiempo, gasto y herramientas. Y, si hay escritura en archivos, envíos de mensajes o cambios en sistemas reales, debe especificar qué acciones requieren autorización humana.
Cómo rankea Muse Wonder: buenos resultados, con condiciones
Meta publica una comparación extensa que incluye Wonder y Full. Conservar ambas columnas importa tanto como mostrar las filas donde el proveedor destaca.
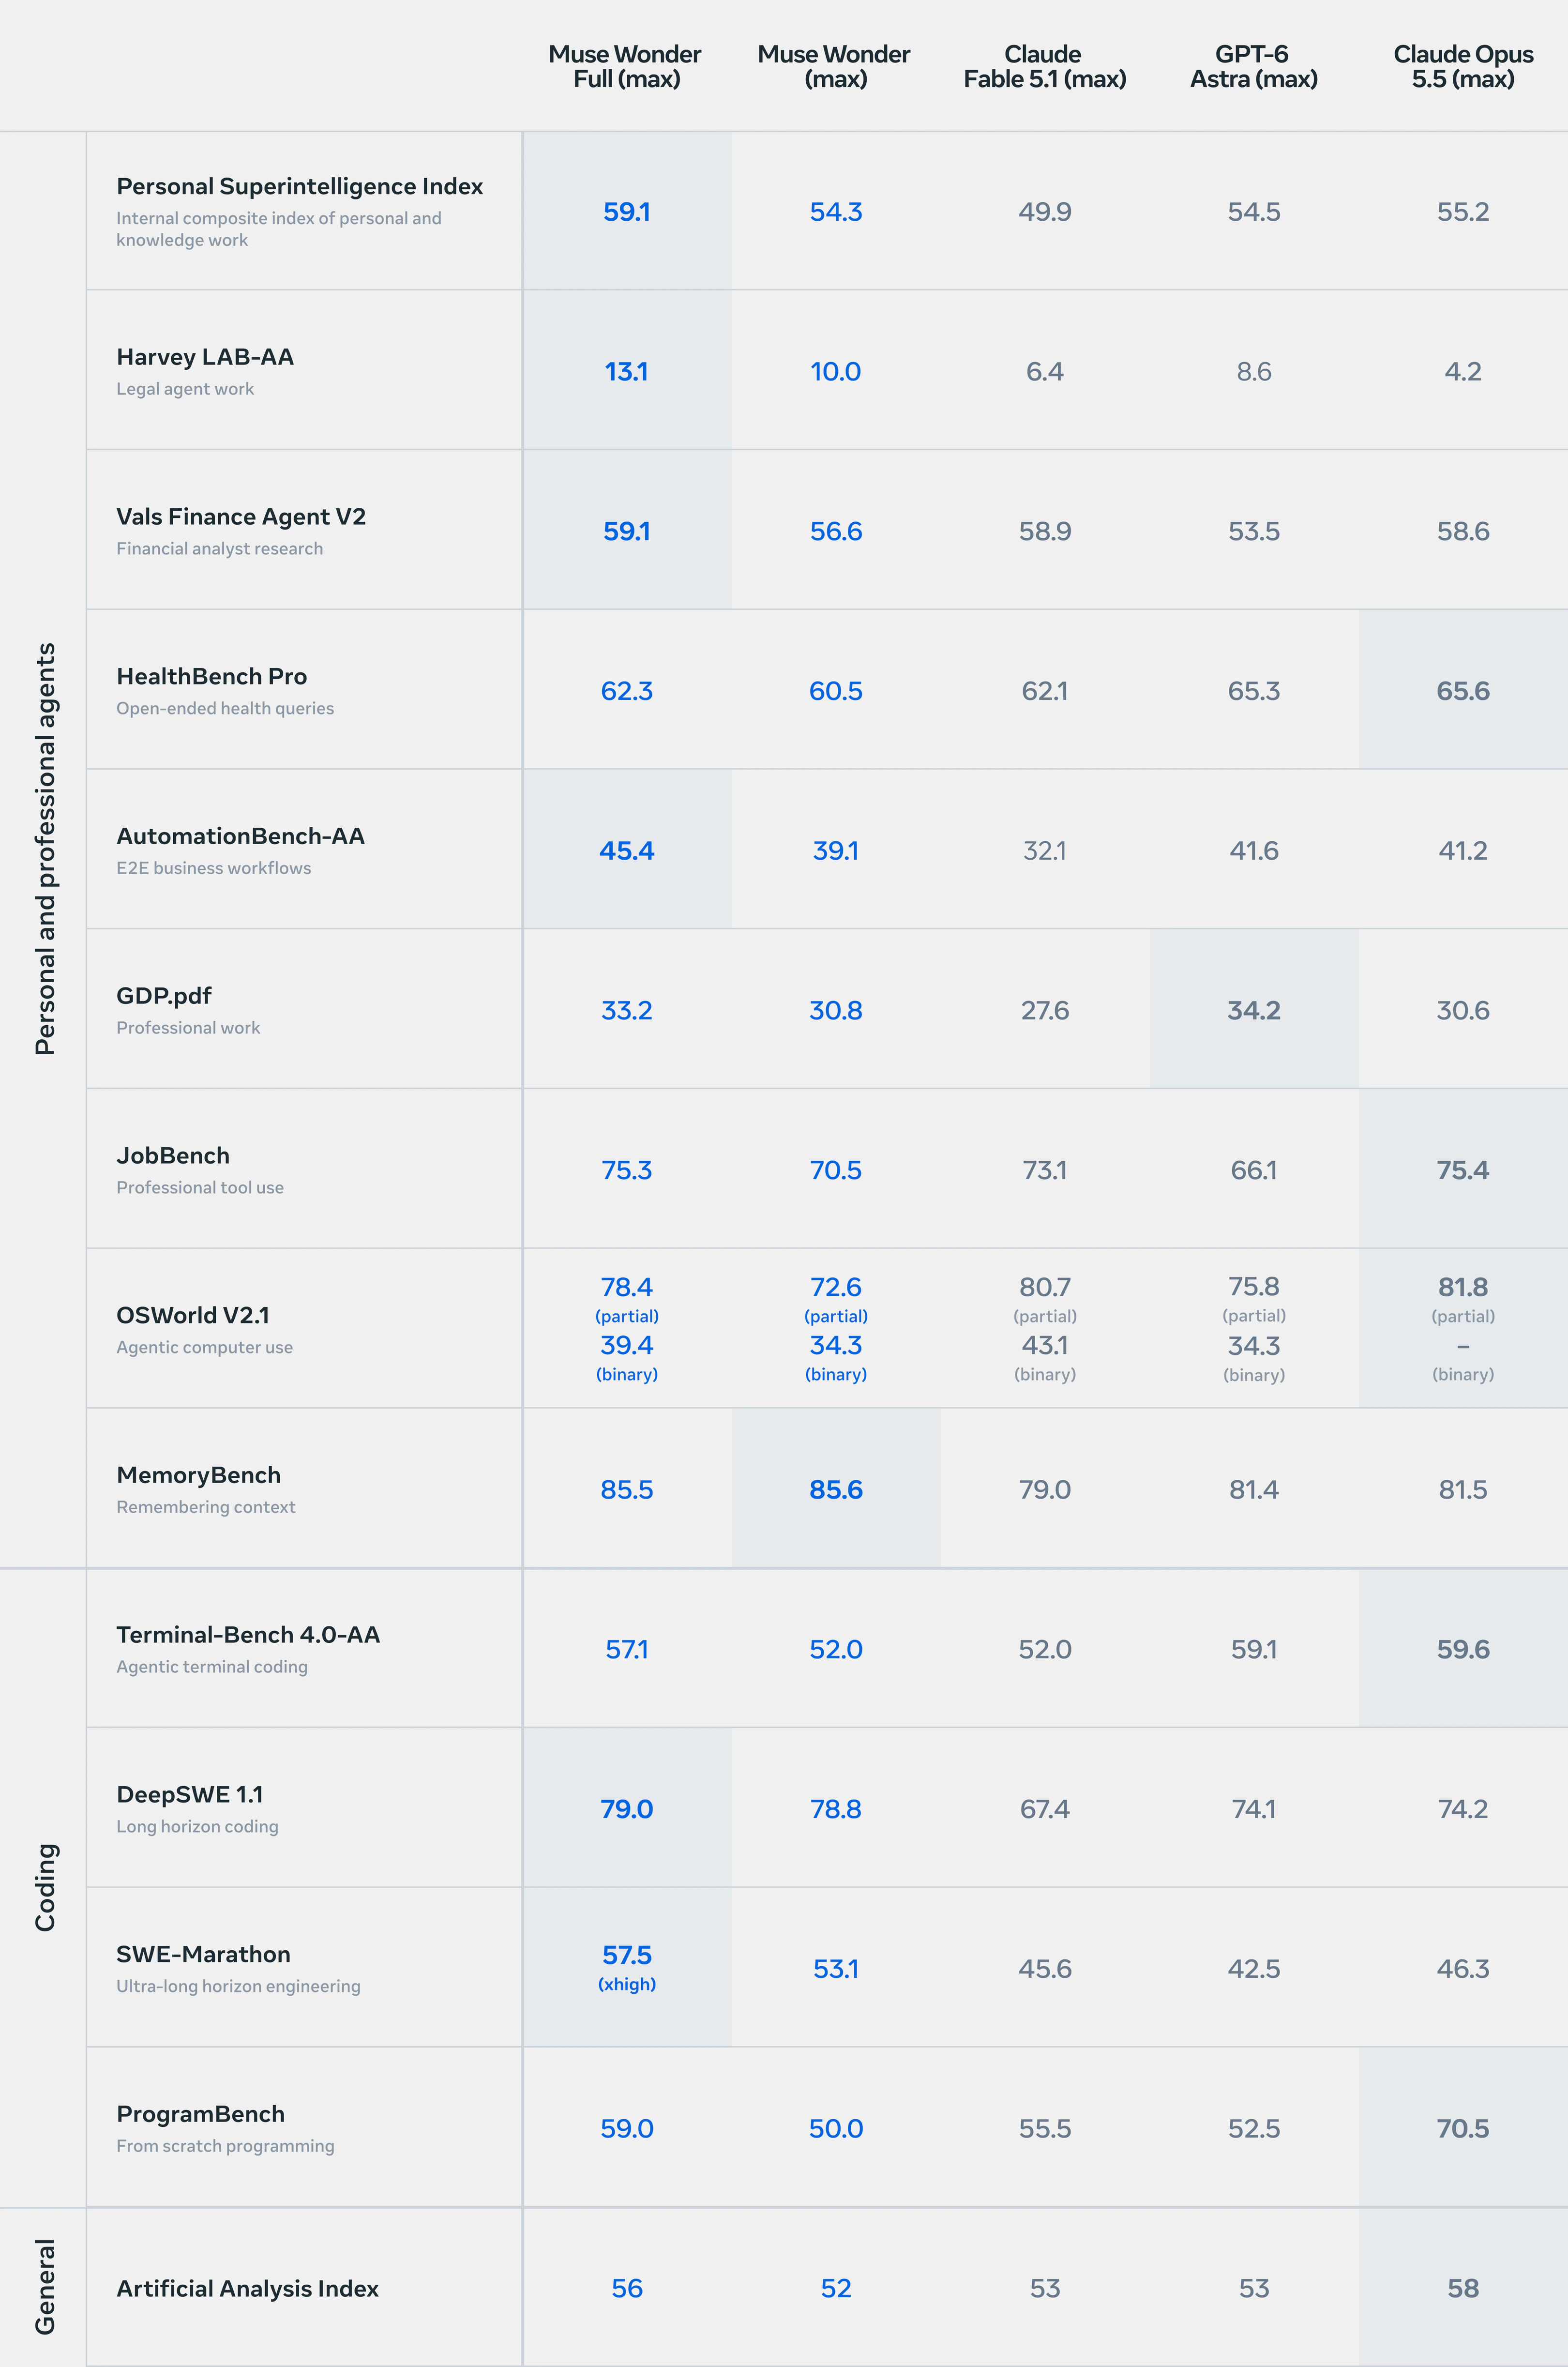
Fuente: investigación oficial de Meta. Original completo sin reconstruir, recolorear ni eliminar filas. Abrilo para consultar las condiciones. Su reproducción no valida independientemente el rendimiento.
Estas filas ilustran por qué “rankea bien” necesita una segunda pregunta: ¿en qué evaluación y con qué variante?
| Evaluación publicada por Meta | Wonder Full | Wonder | Lectura acotada |
|---|---|---|---|
| Personal Superintelligence Index | 59,1 | 54,3 | Índice compuesto interno de Meta. |
| DeepSWE 1.1 | 79,0 | 78,8 | Puntuaciones destacadas en programación de horizonte largo. |
| MemoryBench | 85,5 | 85,6 | Evaluación interna de recuerdo de contexto. |
| ProgramBench | 59,0 | 50,0 | Claude Opus 5.5 figura con 70,5 en la tabla. |
| Artificial Analysis Index | 56 | 52 | Claude Opus 5.5 figura con 58. |
No todas estas puntuaciones son porcentajes. No se deben sumar ni promediar para producir un ranking propio: miden trabajos y escalas distintas.
Qué limita la comparación
La model card explica cómo obtiene los resultados y distingue evaluaciones propias, resultados publicados y ejecuciones de competidores. Que estén juntos en una tabla no significa que cada modelo haya usado el mismo entorno, herramientas o producto.
El Personal Superintelligence Index es un compuesto interno, no una certificación externa de “superinteligencia”. En SWE-Marathon, la tabla incluso conserva una excepción de esfuerzo xhigh para Full frente a los encabezados generales max. Ignorar esas etiquetas cambia lo que el lector cree estar comparando.
También hay un límite al cruzar anuncios: la tabla de Meta usa AutomationBench-AA y OSWorld V2.1. No los trataría como idénticos a AutomationBench y OSWorld 2.0 de otra publicación. Nombres cercanos no garantizan versiones, conjuntos ni criterios comunes.
La conclusión razonable es que Meta aporta evidencia para considerar a Wonder en ciertas tareas largas. No demuestra que todos los usuarios obtendrán el rendimiento de Full ni que la familia gane en todos los casos.
Cuánto cuesta y cómo se accede
Para muse-wonder-1.0, la página oficial de precios indica las siguientes tarifas en Standard mode:
| Uso | Tarifa publicada |
|---|---|
| Entrada, por millón de tokens | US$4 |
| Salida, por millón de tokens | US$20 |
| Entrada en caché, por millón de tokens | US$0,20 |
| Búsqueda web | US$2,50 por mil consultas, adicional al consumo de tokens. |
Estas tarifas corresponden a Wonder por API. No son el precio de Wonder Full ni una mensualidad de Muse Code. Los beneficios y la disponibilidad de suscripciones pueden variar por región; conviene revisar la oferta que muestra el alta, no trasladar un precio visto en redes a cualquier cuenta.
La documentación de suscripciones aclara que la suscripción de Muse Code se aplica a la credencial asociada al CLI. Las claves adicionales de API se facturan por uso. Una mensualidad no implica que todas las llamadas de una aplicación propia estén incluidas.
Para estimar un flujo no alcanza con contar la respuesta final: registrá el consumo completo, las consultas externas y los reintentos, y relacioná ese costo con el trabajo que una persona acepta. Si querés desarrollar ese criterio, el análisis de costo por tarea de Gemini 3.8 Flash explica por qué la tarifa por token no equivale al costo por resultado.
El punto de privacidad que revisaría antes de usar Muse Code
Las suscripciones de Muse Code activan Contributor mode por defecto. Según Meta, ese modo ofrece más uso a cambio de permitir que el contenido se utilice para entrenar modelos futuros. El contenido incluye prompts, código, archivos, contexto y respuestas.
Meta documenta que se puede desactivar en la configuración. En Standard mode, indica que el contenido no se utiliza para entrenar sus modelos. Para Wonder por API, Contributor mode no está disponible en la documentación consultada.
Esta distinción importa más que una celda ganadora si vas a trabajar con un repositorio privado, datos de clientes o documentación interna. No entrenar con los datos tampoco significa automáticamente retención cero: son políticas diferentes que hay que revisar según el contrato y la superficie elegida.
Antes de cargar información sensible, comprobaría el modo activo, los términos aplicables y la autorización de quien controla esos datos. Un ejemplo con información pública puede servir para evaluar capacidad sin convertir una primera prueba en una decisión de tratamiento de datos.
Seguridad: qué está publicado y qué sigue siendo una promesa
Meta describe entrenamiento contra usos dañinos, manejo de información privada y resistencia a instrucciones adversarias. Su model card ya contiene evaluaciones de seguridad. El anuncio, a la vez, anticipa un informe adicional: no corresponde afirmar que no hay información pública ni dar por leído un informe futuro.
Las evaluaciones del proveedor ayudan a identificar qué se probó y bajo qué condiciones. No garantizan que un agente propio vaya a respetar cualquier límite, ni convierten una integración con acceso amplio en una arquitectura segura.
Si un asistente puede leer mensajes, consultar documentos y actuar en una aplicación, el diseño debe separar lectura, propuesta y ejecución. La memoria y la persistencia hacen más importante esa separación, no menos.
Cuándo evaluaría Muse Wonder
Lo consideraría para trabajo donde la continuidad sea un problema observable: cambios de software que requieren varias revisiones, análisis de documentación o procesos con dependencias entre pasos. Para Full, agregaría una comprobación previa: que el producto y el plan disponible permitan usarlo en el flujo que realmente necesitás.
No migraría un sistema estable solamente porque la familia aparece arriba en un índice. Tampoco usaría una demostración de juego o navegador como prueba de confiabilidad para un proceso financiero, legal o de salud.
Un piloto acotado debería responder:
- ¿Mantiene las restricciones originales de la tarea?
- ¿Detecta y corrige errores en vez de perseverar en ellos?
- ¿Pide confirmación en los puntos definidos por el sistema?
- ¿Permite comprobar de dónde obtuvo cada conclusión importante?
- ¿Mejora el resultado aceptado sin aumentar excesivamente costo y revisión?
Es un criterio propuesto para evaluar, no una experiencia que ya haya ejecutado con Wonder.
Mi lectura: Muse Wonder es interesante por combinar continuidad, contexto y trabajo con herramientas. Su adopción depende de la variante disponible, la evidencia para tu tarea y las condiciones de privacidad, no de convertir un ranking en una garantía.
Preguntas frecuentes
¿Puedo usar Wonder Full cambiando el modelo en la API?
No según la documentación consultada. Full está reservado a los planes Power Usage y Maximum Usage de Muse Code. Subir Wonder a razonamiento max tampoco selecciona Full.
¿Active Memory es lo mismo que una ventana de contexto grande?
No. La ventana delimita cuánto contenido puede procesar una ejecución; la propuesta de memoria implica conservar y recuperar información entre conversaciones. La implementación y el control de esa información deben verificarse en el producto o integración elegidos.
¿Meta puede usar mi código para entrenamiento?
La respuesta depende de la superficie y el modo. Las suscripciones de Muse Code usan Contributor mode por defecto y permiten desactivarlo. Standard mode indica que no usa el contenido para entrenar modelos de Meta. Revisá además retención, términos y permisos antes de enviar datos privados.
Fuentes y alcance
Información consultada el 14/10/2026. Precios y acceso sujetos a cambios; resultados atribuidos a sus publicaciones, sin benchmark propio.

Especialista en Agentes de IA · Copenhague
Diseño e implemento agentes IA, MCP servers y harnesses en producción: el loop, las herramientas y el contexto que hacen que un modelo pase de contestar a trabajar. Todo lo que ves en este sitio está construido así.
Artículos relacionados
Cómo Analicé 4 Videos de YouTube en Menos de 1 Hora con Claude Code (Caso Real)
Cómo uso Claude Code para bajar transcripciones de YouTube, analizarlas en paralelo, detectar patrones y construir una estrategia completa en menos del tiempo que tardaría en ver uno solo.
Antes de darle una tarea a una IA, decidí qué no puede hacer
Cómo definir límites y permisos para una IA: qué puede preparar, qué requiere tu aprobación y qué conviene dejar fuera de su alcance.
Grok 4.7: qué es, precio y análisis del modelo de xAI
Qué es Grok 4.7: precio (2/6 USD por millón de tokens), ficha técnica, benchmarks reportados por xAI y para quién conviene el nuevo modelo de SpaceXAI.