Grok 4.7: qué es, precio y análisis del modelo de xAI
En este artículo
Grok 4.7 es el nuevo modelo frontera de SpaceXAI para código, tareas agénticas y trabajo de conocimiento, disponible desde el 21 de septiembre de 2026. Se sirve exactamente al precio de Grok 4.6 — 2 y 6 USD por millón de tokens de entrada y salida — y, según los benchmarks del propio xAI, alcanza rendimiento frontera en ingeniería de software pagando mucho menos por tarea que los modelos premium contra los que compite. La letra chica: todos esos números los mide el proveedor, y la variante rápida que duplica velocidad duplica también el precio.
Si venís de la comparativa entre Opus 5, GPT-5.6 Sol y Gemini, el contexto es directo: contra Sol (4/20 USD) y Fable 5.1 (10/50 USD), la tarifa de Grok 4.7 es entre 2 y 8 veces más baja según el modelo y el componente. Esa brecha de precio con rendimiento comparable es toda la tesis del lanzamiento — y también el punto que hay que verificar con tu propio workload antes de creer.
Los datos volátiles de esta nota están fechados al 21 de septiembre de 2026, día del lanzamiento. Es un análisis documental basado exclusivamente en fuentes oficiales de xAI: no corrí benchmarks propios, y cada tabla cita su fuente.
Qué es Grok 4.7 (y qué no es)
Grok 4.7 es un modelo, no un producto. No lo confundas con Grok Bot, que es otra cosa: un producto beta de agentes persistentes que trabajan en una computadora en la nube. Grok 4.7 es el motor — el modelo que se consume por API o dentro de herramientas como Cursor y Grok Build.
Según el anuncio oficial, es el modelo más capaz de SpaceXAI para código y trabajo de conocimiento, construido sobre una base nueva y más grande que la de Grok 4.6, con un entrenamiento por refuerzo más largo sobre una mezcla de tareas más difícil — ponderada hacia problemas que tardan horas en resolverse. Tres afirmaciones del proveedor que definen el salto:
- Trabaja más tiempo en tareas difíciles: el entrenamiento apuntó a problemas de varias horas, no a preguntas cortas.
- Verifica mejor su propio trabajo: la mejora declarada más relevante para agentes de código, donde un error temprano contamina todo lo que sigue.
- Entiende nativamente el harness de Grok Bot: fue entrenado para el entorno de herramientas y contexto de ese producto, lo que según xAI lo mejora en tareas conversacionales y conocimiento general.
Imagen oficial del lanzamiento. Fuente: xAI
Todo esto es capacidad declarada por el proveedor en su página de lanzamiento. Es la fuente más autorizada para saber qué pretende el modelo; no es validación independiente de que el rendimiento se sostenga en tu caso.
Ficha técnica de Grok 4.7
Todo lo de esta tabla viene de la documentación oficial para desarrolladores y la página del modelo, consultadas el 21 de septiembre de 2026:
| Campo | Valor |
|---|---|
| Identificador de API | grok-4.7 |
| Ventana de contexto | 500.000 tokens |
| Corte de conocimiento | Mayo de 2026 |
| Entradas / salidas | Texto e imagen → texto |
| Límite de salida | Sin límite de salida de texto |
| Esfuerzo de razonamiento | low, medium, high (default), xhigh |
| APIs | Responses y Chat Completions |
| Herramientas | Function calling, web search, X search, code execution |
| Batch API | No soportado |
| Rate limits | 150 requests/s · 50M tokens/min |
Dos detalles que importan si construís sobre el modelo. Primero: en la Responses API, grok-4.7 devuelve siempre el razonamiento encriptado (reasoning.encrypted_content), para conservar el pensamiento del modelo entre turnos de una conversación sin exponerlo — en loops agénticos largos, hay que pasar esos items de vuelta sin modificarlos. Segundo: la documentación recomienda explícitamente setear prompt_cache_key para que las requests de una misma conversación caigan en el mismo server y el cache de prompt funcione; sin eso, advierte la misma documentación, es común pagar entrada completa en un server frío. Es el tipo de detalle de harness que decide el costo real más que la tarifa de lista.
Grok 4.7 precio: cuánto cuesta por token y por tarea
Precio por token
La tabla oficial de precios de la API, en USD por millón de tokens:
| Contexto | Entrada | Cacheada | Salida |
|---|---|---|---|
| Menos de 200K tokens | $2,00 | $0,50 | $6,00 |
| Desde 200K tokens | $4,00 | $1,00 | $12,00 |
Tres lecturas de esta tabla:
- Es el precio de Grok 4.6, sin cambio. La tabla oficial lista ambos modelos a idéntica tarifa. El "qué cambia" del lanzamiento es el rendimiento, no el precio.
- El umbral de 200K no es progresivo. Cuando el prompt alcanza 200K tokens, todo el request — no solo el excedente — se factura a tarifa larga. Con la mitad de la ventana llena ya pagás el doble; el cache de prompt pasa de optimización a necesidad.
- Entre 2 y 8 veces más barato que los premium. Contra Sol (4/20 USD) y Fable 5.1 (10/50 USD), la tarifa de Grok 4.7 es entre 2 y 8 veces más baja según el modelo y el componente. Es la base del tagline del lanzamiento: "twice as fast, at half the price of comparable models".
Sobre ese tagline, la letra chica: la velocidad doble corresponde a la variante Fast — el mismo modelo en infraestructura más rápida, facturada al doble de tarifa, disponible solo en Cursor y Grok Build, fuera del free tier de Grok Build y de la API pública. El modelo estándar se sirve, en palabras del propio anuncio, "al mismo precio y velocidad que Grok 4.6". Dos verdades del proveedor que conviene no fundir en una sola promesa. Además, el endpoint regional de Estados Unidos (us.api.x.ai) suma un 10% sobre las tarifas.
Precio por tarea: el número que decide
La tarifa por token no te dice cuánto cuesta resolver una tarea. El anuncio incluye un gráfico de CursorBench 4.0 contra costo promedio por tarea; estos son los puntos publicados (simulación de xAI, su harness):
| Modelo (effort) | Score CursorBench 4.0 | Costo promedio por tarea |
|---|---|---|
| Grok 4.7 (xhigh) | 46,3% | $6,01 |
| Grok 4.7 (high) | 43,9% | $4,69 |
| Grok 4.7 (medium) | 41,6% | $3,49 |
| Grok 4.7 (low) | 33,1% | $1,58 |
| GPT-5.6 Sol (max) | 41,7% | $8,23 |
| Claude Opus 5 (max) | 46,6% | $11,95 |
| Claude Sonnet 5 (max) | 34,1% | $7,17 |
| Claude Fable 5.1 (max) | 51,8% | $17,28 |
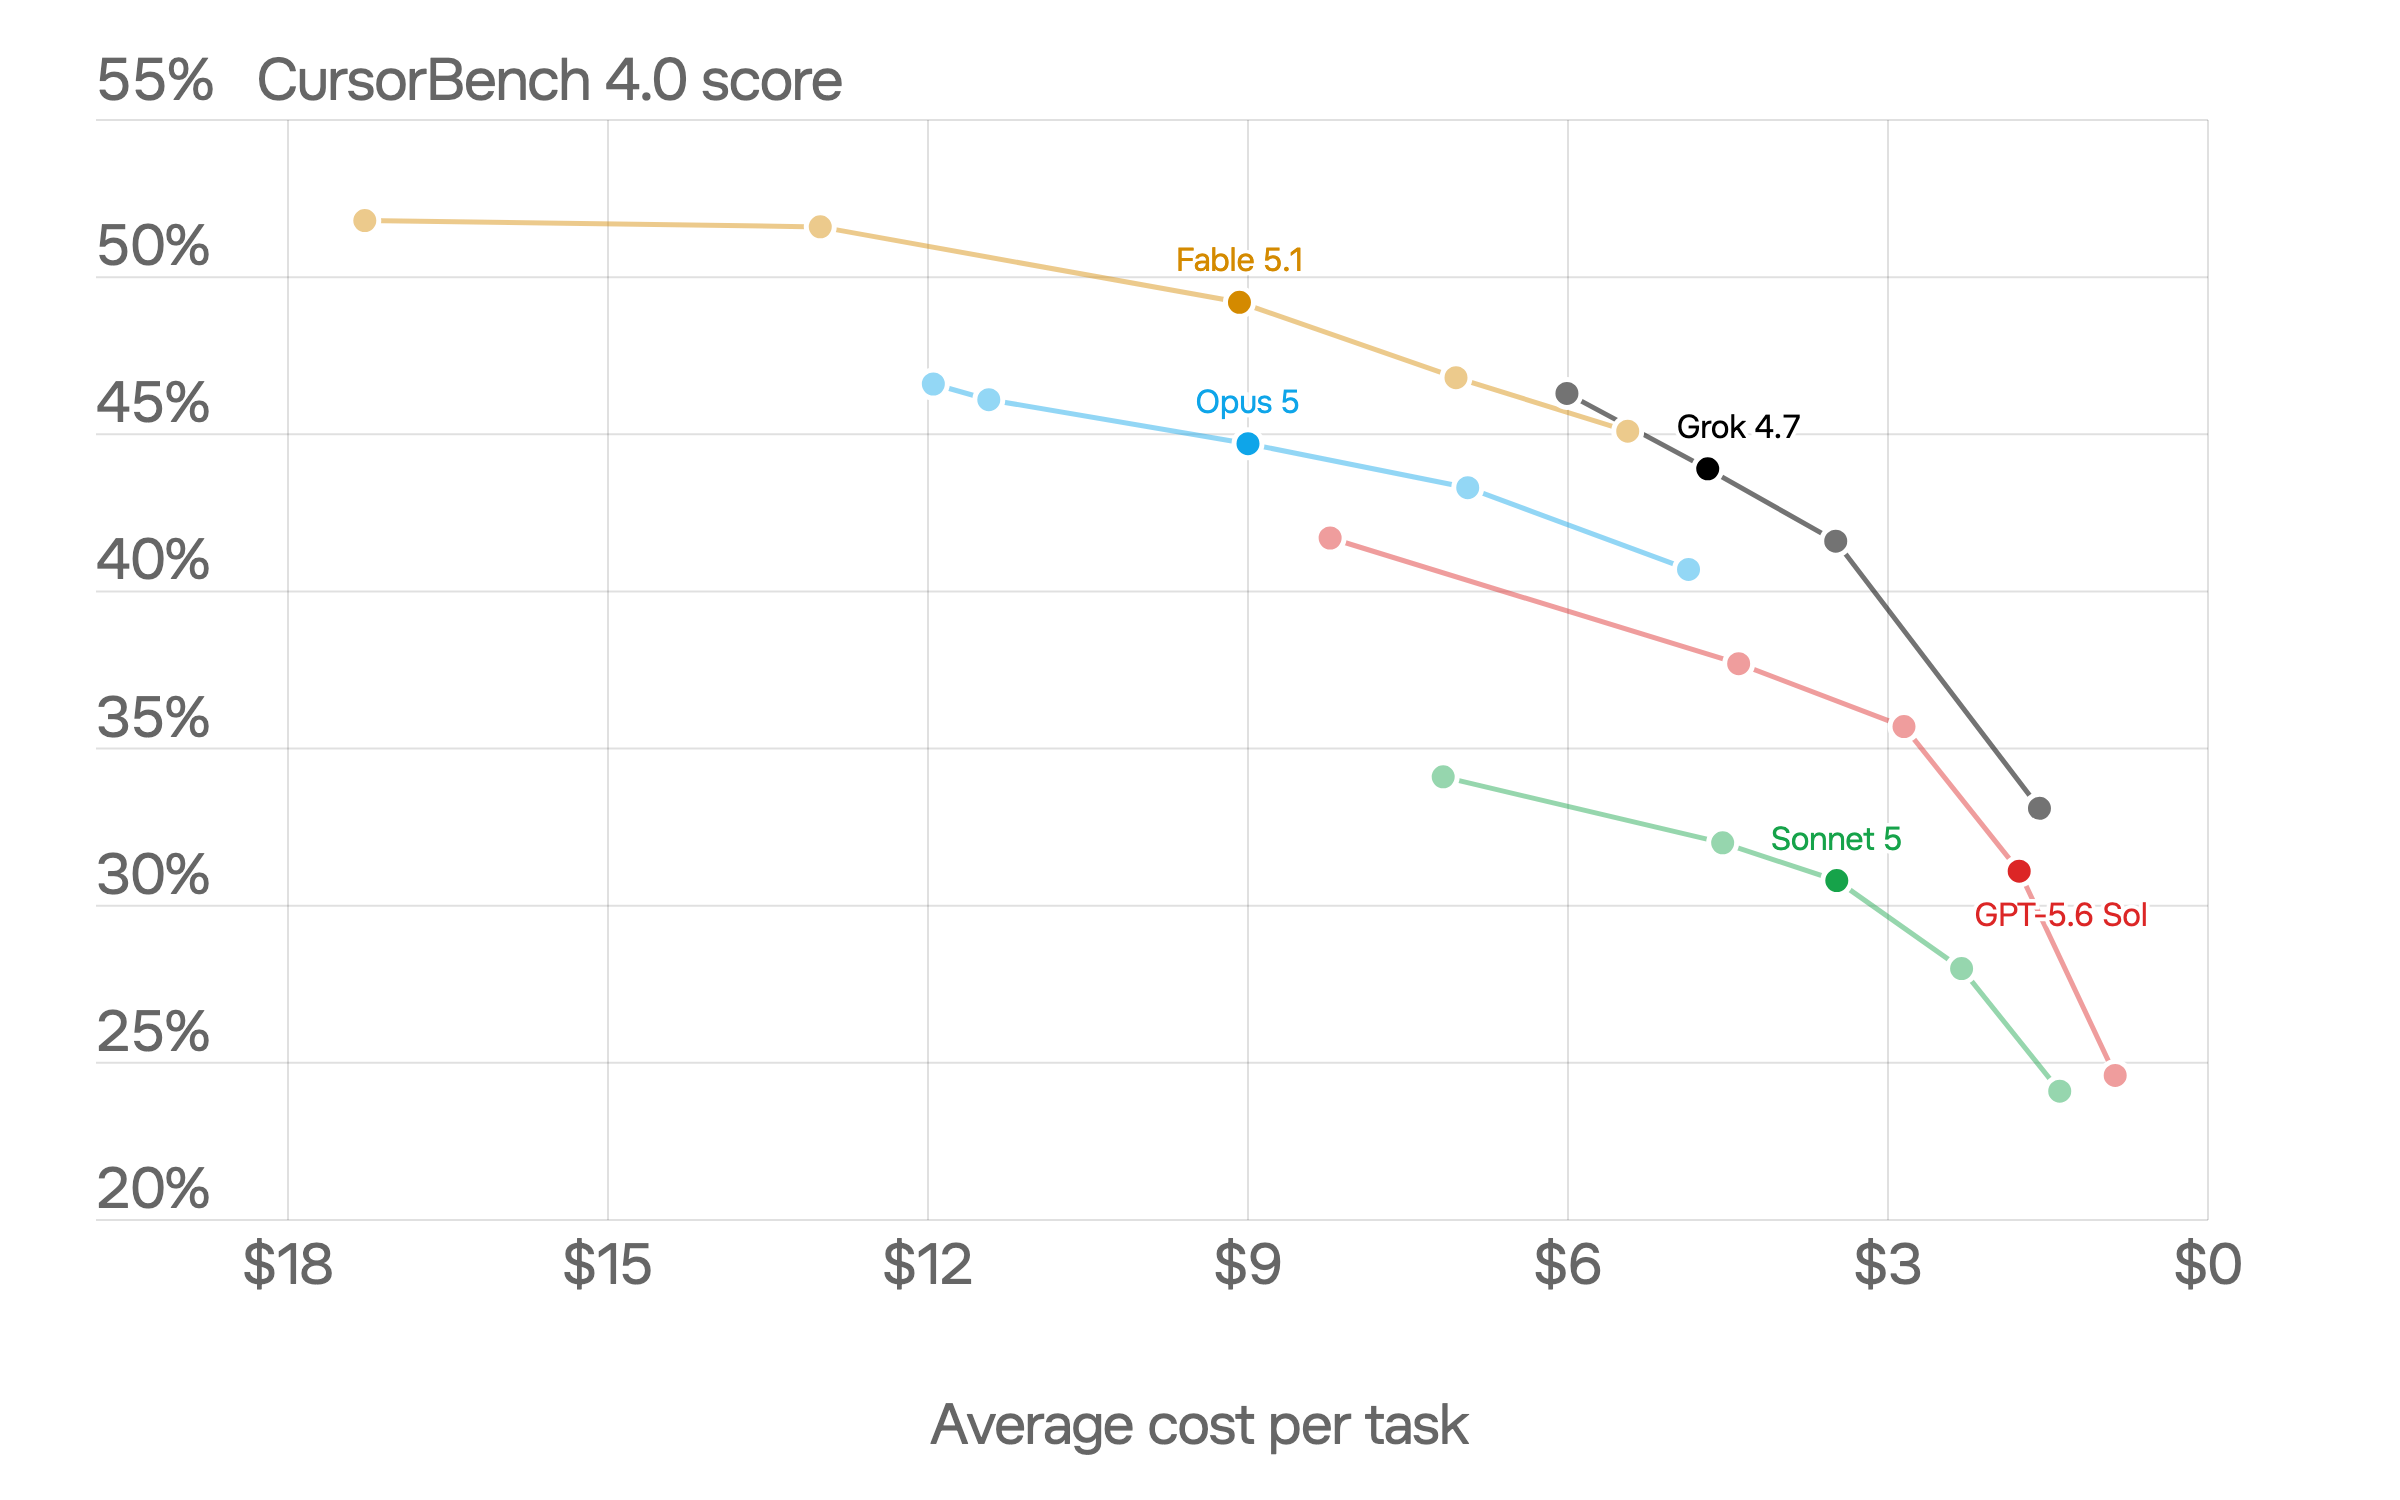
Gráfico oficial del anuncio: CursorBench 4.0 contra costo promedio por tarea. Fuente: xAI
Aquí está el argumento real del lanzamiento: con 46,3% a $6,01 por tarea, Grok 4.7 cuesta la mitad que Opus 5 por score casi idéntico, y un tercio de Fable 5.1 — que sí gana, pero a $17,28 por tarea. xAI se llama a sí mismo "frontera en price-performance" en este benchmark, y dentro de esta tabla la frase se sostiene. El límite: es la simulación del proveedor, con su propio harness. Es el mismo análisis de costo por tarea que hice con Gemini 3.8 Flash: la tarifa por token es publicidad; el costo por tarea de tu workload es el número que decide.
Análisis: lo que muestran los benchmarks (todos de xAI)
Advertencia metodológica única para toda la sección: estos números los reporta xAI, en evaluaciones que corrió xAI, con su propio harness, midiendo también a los modelos competidores. No hay verificación independiente publicada al día del lanzamiento. Cada tabla cita su fuente, no se mezclan harnesses, y los modelos se comparan al nivel de effort que publicó el proveedor.
Ingeniería de software y trabajo largo
Fuente: anuncio de lanzamiento, 21 de septiembre de 2026. El asterisco marca que el score de Grok 4.7 en DeepSWE es de high effort.
| Benchmark | Grok 4.7 (xhigh) | Grok 4.6 (high) | GPT-5.6 Sol (max) | Fable 5.1 (max) |
|---|---|---|---|---|
| CursorBench 4.0 (código largo) | 46,3% | 40,4% | 41,7% | 51,8% |
| DeepSWE v1.1 | 71,0%* | 65,2% | 72,7% | 70,0% |
| Terminal-Bench 4.0 (terminal, horas) | 38,0% | 20,3% | 37,3% | 57,9% |
| EEBench (ingeniería eléctrica) | 64,0% | 53,0% | 39,4% | 56,4% |
Lectura honesta de esta tabla: Grok 4.7 le gana a su antecesor en los cuatro renglones (el salto de Terminal-Bench, de 20,3% a 38,0%, casi lo duplica) y a Sol en tres de cuatro — en DeepSWE es Sol el que supera, 72,7% contra 71,0%. Contra Fable 5.1 el resultado se reparte: Fable gana CursorBench y Terminal-Bench; Grok 4.7 gana DeepSWE y EEBench. Si tu criterio es "el mejor score sin importar el costo", esta tabla sigue diciendo Fable. Si tu criterio es costo-efectivo, dice Grok 4.7.
Trabajo profesional de conocimiento
Los benchmarks de knowledge work del anuncio, donde las tareas son las que hacen abogados, enfermeras y analistas financieros:
| Benchmark | Grok 4.7 (xhigh) | Grok 4.6 (high) | GPT-5.6 Sol (max) | Fable 5.1 (max) |
|---|---|---|---|---|
| AA Briefcase v1.1 (oficina, horas) | 1.657 | 1.546 | 1.487 | 1.678 |
| Harvey Legal Agent (legal) | 19,6% | 15,8% | 2,5% | 6,7% |
| HealthBench Professional (clínico) | 56,7% | 48,5% | 60,5% | 62,1% |
Y en GDPval (Elo, según el gráfico del anuncio): Fable 5.1 (max) 1.735, Grok 4.7 (xhigh) 1.695, Grok 4.6 (high) 1.605, GPT-6 Astra (max) 1.542.
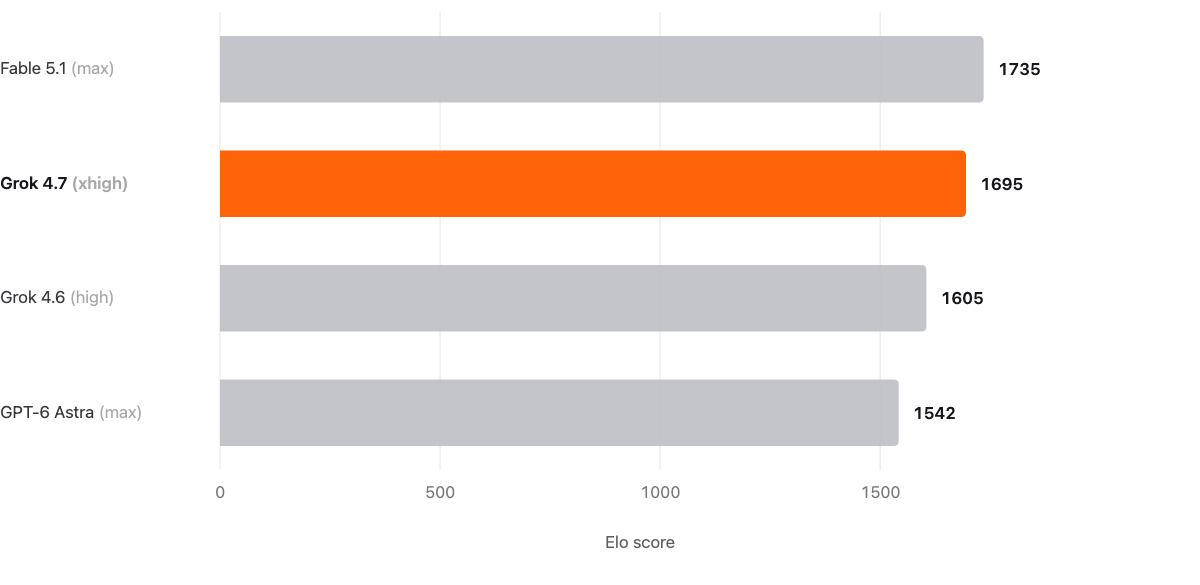
Gráfico oficial del anuncio: Elo de GDPval en trabajo profesional. Fuente: xAI
El patrón se repite: cerca de la frontera, encima de su antecesor, con dos resultados llamativos. Harvey Legal es el más extremo — 19,6% contra 2,5% de Sol y 6,7% de Fable — y conviene leerlo con la duda metodológica activa: un benchmark de un proveedor donde el propio proveedor saca semejante ventaja merece verificación independiente antes de tomar una decisión de compra con ese número. En GDPval, la brecha con Fable es de 40 puntos de Elo, no de otro planeta.
Seguridad y ciberseguridad: cifras del proveedor
El anuncio presenta un stack de salvaguardas enteramente nuevo, con tres afirmaciones medibles:
- Resistencia a jailbreaks: xAI lo llama "el modelo más fuerte que probamos" en rechazos y jailbreak. Benchmark propio, población propia.
- Biosafety: encabeza el benchmark de biosafety de LatchBio con 62,4%. Es la única cifra de un tercero citada en el lanzamiento — pero corrida y reportada por xAI, no una auditoría publicada por LatchBio.
- Ciberseguridad dual-use: en HackerBench v0.3 — benchmark de xAI para tareas cibernéticas riesgosas — deja pasar solo el 3,3% de los prompts dual-use riesgosos "bloqueando rara vez el trabajo legítimo de seguridad". Además, partners de ciberseguridad seleccionados reciben acceso invite-only a las capacidades de red team para investigación defensiva.
El equilibrio que describe el proveedor — bloquear lo riesgoso sin estorbar el uso legítimo — es exactamente el problema difícil de los modelos con capacidades ofensivas, y la lección de GPT-6 Astra aplica completa: cuando un laboratorio frontera reporta sus propios números de seguridad en el día del lanzamiento, lo correcto es registrarlos como claims del proveedor y esperar evidencia externa. Nada de esta sección es validación independiente.
Grok 4.7 y Grok Bot: dos cosas distintas
Porque el lanzamiento menciona a Grok Bot en cada párrafo, la frontera merece su propia sección:
| Grok 4.7 | Grok Bot | |
|---|---|---|
| Qué es | Un modelo | Un producto |
| Cómo se consume | API, Cursor, Grok Build, gateways | App/entorno propio de agentes persistentes |
| Qué hace | Razona, escribe código, usa herramientas | Delega tareas a agentes con memoria en una computadora cloud |
| Relación | Entiende nativamente su harness | Usa modelos (4.7 entre ellos) como motor |
La relación es real pero jerárquica: el modelo alimenta al producto. Si lo que evaluás es un agente que trabaje solo en la nube, lo tuyo es el análisis de Grok Bot. Si lo que evaluás es qué motor de razonamiento poner en tu stack — vía API, Cursor o tu propio harness — lo tuyo es este artículo.
Dónde está disponible Grok 4.7
Desde el lanzamiento, según el anuncio y la documentación:
| Superficie | Estado al 21/9/2026 |
|---|---|
| Cursor | Disponible en todos los planes |
| Grok Build | Modelo por defecto del agente de código; se puede probar gratis (Fast no entra al free tier) |
| API de xAI | Disponible (grok-4.7); endpoint regional US con +10% |
| Gateways | OpenRouter, Vercel, Cloudflare |
| Grok 4.7 Fast | Solo Cursor y Grok Build, al doble de tarifa; no en la API pública |
Lo que el anuncio no dice: disponibilidad en la app de Grok o en X. No la menciona al día del lanzamiento; si llega, será una actualización de esta nota.
Para quién tiene sentido (veredicto)
Opinión mía, separada de los datos de arriba:
- Para código agéntico con presupuesto, es el candidato obvio del día: precio de Grok 4.6 con rendimiento frontera según su creador, y el costo por tarea reportado más competitivo de su clase. Si tu harness ya corre sobre Cursor o API, probarlo es barato: cambiás una línea de configuración de modelo y medís.
- Para workloads de contexto largo, hacé la cuenta del umbral de 200K antes: la ventana es de 500K, pero pasada la mitad todo el request paga tarifa doble. Con buen prompt caching el input cacheado a $0,50 amortigua; sin él, no.
- Si necesitás el techo absoluto de razonamiento, los números del propio xAI siguen poniendo a Fable 5.1 arriba en los benchmarks más pesados. Por ese margen pagás entre 5 y 8 veces más por token — y ahí la decisión es del workload, no de la moda.
- Como pieza de harness, el cambio material está en la selección de modelo: mismo precio, más capacidad declarada, herramientas server-side (web search, X search, code execution) y razonamiento encriptado entre turnos. Contexto, permisos y verificación siguen siendo tuyos.
La regla de siempre: un modelo nuevo no arregla un harness flojo. Grok 4.7 compite en la capa del motor; tu ventaja real sigue estando en el contexto que le das, las herramientas que le permitís y cómo verificás lo que devuelve. Si querés pensarlo para un proceso concreto, hablemos.
Preguntas frecuentes
¿Qué es Grok 4.7?
Grok 4.7 es el modelo frontera de SpaceXAI para código, tareas agénticas y trabajo de conocimiento, lanzado el 21 de septiembre de 2026. Se sirve en la API de xAI con el identificador grok-4.7, con ventana de contexto de 500.000 tokens, entrada de texto e imagen, y niveles de esfuerzo de razonamiento low, medium, high y xhigh.
¿Cuánto cuesta Grok 4.7?
Según la página oficial de precios de xAI, Grok 4.7 cuesta 2 USD por millón de tokens de entrada, 0,50 USD por millón de tokens cacheados y 6 USD por millón de tokens de salida, mientras el prompt no alcance los 200.000 tokens. Desde ese umbral, todo el request se factura a 4/1/12 USD. La variante Fast cuesta el doble y no está en la API pública.
¿Grok 4.7 es mejor que Grok 4.6?
En los benchmarks que publica el propio xAI, Grok 4.7 supera a Grok 4.6 en todas las tablas del anuncio: CursorBench 4.0 (46,3% contra 40,4%), DeepSWE v1.1 (71,0% contra 65,2%), EEBench (64,0% contra 53,0%) y Terminal-Bench 4.0 (38,0% contra 20,3%), al mismo precio. Son números del proveedor con su propio harness, sin verificación independiente.
¿Grok 4.7 y Grok Bot son lo mismo?
No. Grok 4.7 es un modelo que se consume por API o dentro de herramientas como Cursor y Grok Build. Grok Bot es un producto aparte: agentes persistentes que trabajan en una computadora en la nube. Según el anuncio, Grok 4.7 fue entrenado para entender nativamente el harness de Grok Bot, pero son capas distintas del sistema.
¿Dónde puedo usar Grok 4.7?
Desde el lanzamiento está disponible en Cursor (todos los planes), en Grok Build como modelo por defecto del agente de código, en la API de xAI con su endpoint regional de Estados Unidos, y en gateways como OpenRouter, Vercel y Cloudflare. La variante Fast solo existe en Cursor y Grok Build.
¿Los benchmarks de Grok 4.7 son independientes?
No. Todos los números publicados el día del lanzamiento los reporta xAI en evaluaciones que corrió xAI con su propio harness, comparando modelos rivales evaluados también por xAI. La única cifra de un tercero (LatchBio, 62,4% en biosafety) también la reporta xAI. No hay verificación independiente publicada todavía.
Fuentes
Todas las fuentes de esta nota son oficiales de primera parte, consultadas el 21 de septiembre de 2026:
| Fuente | Qué respalda |
|---|---|
| xAI — Introducing Grok 4.7 | Lanzamiento, mejoras del modelo, benchmarks, seguridad, disponibilidad |
| xAI — Grok 4.7 overview | Ficha técnica, variante Fast, dónde corre, caching |
| xAI — Modelo grok-4.7 | Contexto, precios, rate limits, Batch no soportado |
| xAI — Pricing | Tarifas cortas/largas, cache, umbral 200K, endpoint US |
| xAI — Release notes | Entrada del 21/9/2026, razonamiento encriptado, Grok 4.6 (12/8) |

Especialista en Agentes de IA · Copenhague
Diseño e implemento agentes IA, MCP servers y harnesses en producción: el loop, las herramientas y el contexto que hacen que un modelo pase de contestar a trabajar. Todo lo que ves en este sitio está construido así.
Artículos relacionados
GLM-5.3 vs GLM-5.3-Flash: cuál elegir según la tarea
Compara GLM-5.3 y GLM-5.3-Flash por modalidad, rendimiento, arquitectura y costo para elegir qué modelo probar según la tarea.
Qué es Jev: el modelo que no genera texto y cuándo conviene
Analizo Jev de TypeSafe AI: cómo funciona un System One model, qué claims de 200x se sostienen frente a la evidencia independiente, cuánto cuesta y cuándo usarlo.
¿La IA nos va a matar? Miedo, intereses y qué hay de real
El pánico por la IA mezcla riesgos operativos reales, intereses comerciales que viven del FOMO y una carrera geopolítica. Un análisis racional con fuentes.