Qué es Jev: el modelo que no genera texto y cuándo conviene
En este artículo
TypeSafe AI lanzó Jev el 15 de septiembre de 2026, y el anuncio tiene una idea que rompe con todo lo demás que se publicó este año: un modelo de frontera que renuncia a generar texto. No conversa, no redacta, no escribe código. Recibe un estado, lo evalúa contra preguntas tipadas y devuelve decisiones con probabilidades calibradas que tu software puede consumir directamente.
Detrás del lanzamiento hay un dato que explica la ambición: TypeSafe salió de dos años de stealth con US$40 millones de capital seed liderado por DCVC, y su fundador es Diogo Almeida, ex-investigador de OpenAI y Google Brain. Según la bio oficial de la empresa, Almeida co-inventó RLHF e InstructGPT — los métodos que terminaron sosteniendo ChatGPT. Su tesis ahora es la contraria: los modelos optimizados para charlar con personas son los equivocados para automatizar software.
Mi veredicto corto: como componente de decisiones dentro de un sistema, Jev es el lanzamiento más interesante del año en la capa de modelos, y la evidencia independiente confirma velocidad y costo extremos. Pero la precisión es desigual por tarea — en una prueba independiente perdió con claridad frente a Claude Haiku 4.5 — y los títulos de 200x más rápido y 400x más barato vienen de benchmarks propios del vendor con matices que hay que leer.
Esta evaluación se apoya en el anuncio oficial de TypeSafe y en pruebas independientes de Every, JevBench, LangChain y Aman Kumar. No es un benchmark propio: cada resultado conserva el harness con el que se midió, porque no son comparables entre sí.
Qué es Jev: la ficha en una tabla
Jev es lo que TypeSafe llama un System One model, tomando prestada la distinción de Daniel Kahneman entre pensamiento rápido e intuitivo (Sistema 1) y razonamiento lento y deliberado (Sistema 2). La idea: gran parte del trabajo que hoy le damos a un LLM no necesita prosa, sino decisiones rápidas, baratas y consistentes.
| Aspecto | Jev (TypeSafe AI) |
|---|---|
| Qué es | Modelo de decisiones: estado adentro, decisiones tipadas con probabilidades afuera |
| Qué NO hace | No genera texto, no conversa, no redacta, no escribe código |
| Lanzamiento | 15 de septiembre de 2026, early access por waitlist |
| Empresa | TypeSafe AI (San Francisco), fundada por Diogo Almeida; US$40M seed liderado por DCVC |
| Método de entrenamiento | RLCD — Reinforcement Learning for Calibrated Decisions (nombre oficial del vendor) |
| Precio de lista | US$0,042 por millón de tokens de entrada; salida gratis |
| Latencia declarada | 70–500 ms end-to-end, muestreo paralelo en una sola consulta |
| Límites conocidos | Solo texto (sin imágenes), hasta 255 opciones por pregunta tipo choice |
Cómo funciona: estado adentro, decisiones tipadas afuera
La mecánica es simple de describir. Le pasás a Jev un estado — un párrafo, un ticket de soporte, una factura, el estado de un programa — y una lista de preguntas tipadas con las respuestas posibles ya definidas. Jev responde cada pregunta con uno de tres tipos de valor:
- Probabilidad sí/no: "¿este reclamo pide un reembolso?" con su nivel de confianza.
- Choice: una opción elegida entre las que definiste, con un máximo de 255. Para listas grandes, el modelo puntúa primero y elige después en dos etapas.
- Score: una posición en una escala numérica que vos definís.
La diferencia de fondo con un LLM está en el muestreo. Un modelo de lenguaje genera token a token, cada pieza condicionada por la anterior; Jev evalúa todas las respuestas en paralelo en una sola pasada. De ahí salen los 70–500 ms y el costo de lista: US$0,042 por millón de tokens de entrada, con la salida gratis — "demasiado barata para medir", en palabras del propio anuncio.
El método de entrenamiento se llama RLCD (Reinforcement Learning for Calibrated Decisions) y es la tercera pata de la propuesta: en lugar de optimizar preferencia humana (RLHF) o recompensas verificables (RLVR), optimiza calibración — que la confianza declarada correlacione con la precisión real. Ojo: RLCD es hoy el nombre que la empresa le da a su método; no vi un paper público revisado que lo respalde, así que lo reporto como claims del vendor.
El nombre Jev viene de William Stanley Jevons y su paradoja económica: cuando la eficiencia del carbón aumentó, el consumo creció en vez de bajar. La apuesta de Almeida es que cada orden de magnitud de abaratamiento de la inteligencia abre más casos de uso de los que cierra.
"No puede alucinar": qué es verdad y qué no
Este es el claim que más se repite en la cobertura y el que más cuidado necesita. Lo que Jev garantiza es validez de tipo: la salida siempre encaja en el esquema definido. Nunca devuelve un campo que no existe, un formato roto o texto donde esperabas un número. Almeida lo plantea en serio: un solo contraejemplo de error de tipo falsificaría el claim, y sostiene que es matemáticamente imposible porque el esquema está construido en la salida misma.
Lo que no garantiza es que la respuesta sea correcta. Si Jev evalúa si una factura es fraudulenta, siempre devolverá un valor válido — pero puede ser un valor errado, con una probabilidad encima. La promesa de calibración es que cuando el modelo dice 99% de confianza, acierte cerca del 99% de las veces. Esa es exactamente la hipótesis que hay que exigirle en pruebas propias.
El argumento de por qué importa es razonable y viene del propio anuncio: en un agente, un tool call alucinado es molesto; en un sistema con garantías de latencia o enterrado varias capas abajo en una cadena de dependencias, es un problema de otra gravedad. Aquí está el gráfico oficial:
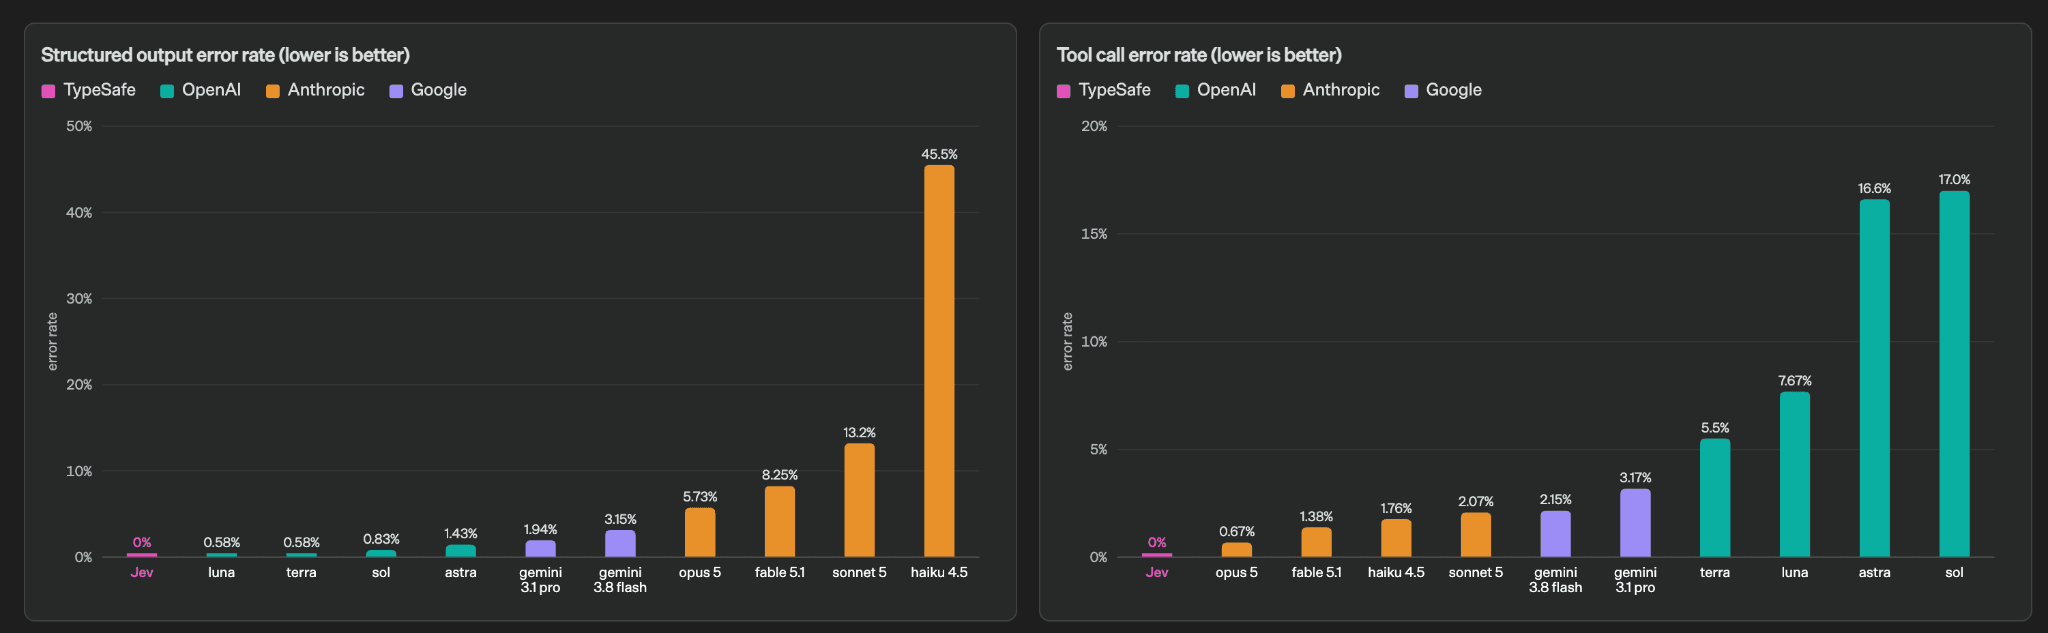
Figura del anuncio sobre alucinación y seguridad de tipos. Fuente: TypeSafe AI
Un matiz que el propio vendor declara: los números de los LLMs en ese gráfico vienen de OpenRouter, así que hay posible sesgo de routing — las consultas más complejas pueden haber ido a parar a mejores modelos.
Los números de TypeSafe, con la metodología al lado
Los títulos que dieron la vuelta al mundo — 193,6x más rápido y 444,6x más barato que LLMs de frontera — salen de los workflow evals de la empresa, y el propio anuncio explica cómo se midieron. Resumo la metodología con sus matices incluidos:
- Todos los modelos corren el mismo grafo de trabajo (un "workflow" representado en código); no se optimiza una clasificación con ground truth ni se permite cambiar el harness.
- La referencia de "respuesta correcta" es el promedio de GPT-6 Astra y Fable 5.1, los modelos más capaces externos. El vendor admite que esto sesga a favor de OpenAI y Anthropic, y que probablemente subestima a su propio modelo y a los de DeepSeek.
- Los LLMs compiten envueltos en su adapter System One, que los obliga a devolver decisiones con probabilidades. Es la forma más precisa que encontraron de pedirle decisiones a un LLM, pero también más lenta y cara.
- Los workflows fueron armados por su equipo de capacidades, aunque fuera de la distribución de entrenamiento. Sesgo posible, reconocido.
- Las latencias se midieron desde sus laptops en la costa oeste de EE. UU.
- Y sobre el precio: "no podemos probar que no esté subsidiado", admite el anuncio; esperan que baje, no que suba.
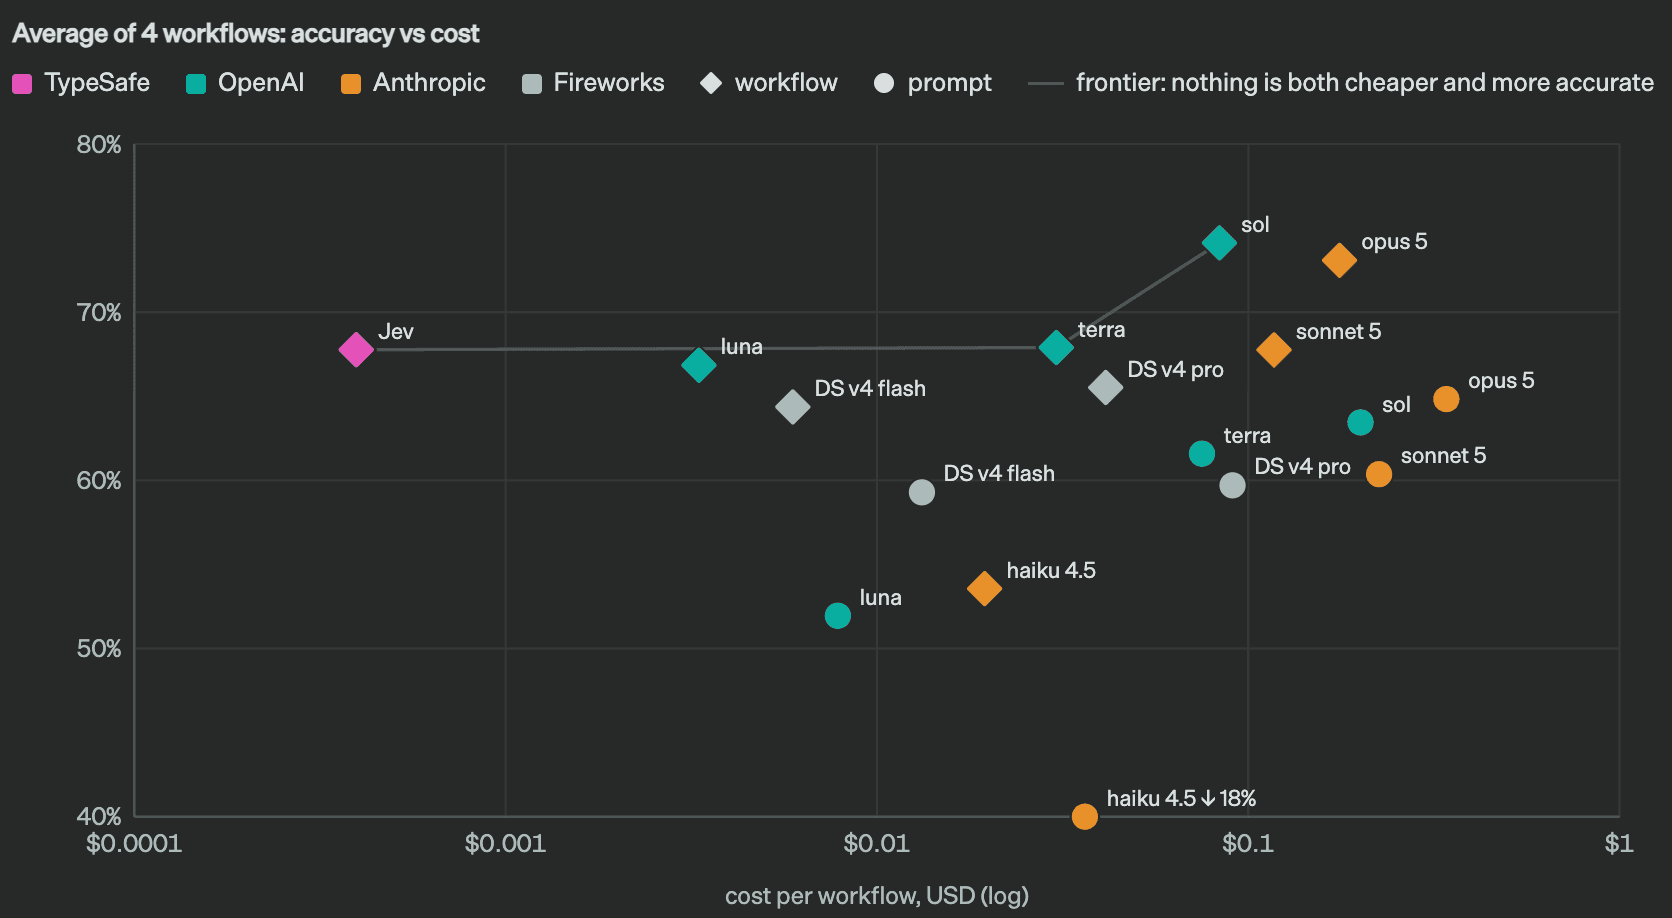
Jev sobre la frontera de Pareto en los workflow evals propios. Fuente: TypeSafe AI
Mi lectura: es inusual — y bienvenido — un anuncio que publica sus propios matices con este nivel de detalle. Pero siguen siendo benchmarks del vendor. La pregunta que importa se responde afuera.
Qué dicen las pruebas independientes
A la fecha, hay al menos cuatro evaluaciones serias de terceros. Cada una con su propio harness, así que no son comparables entre sí; sirven como piezas de un rompecabezas.
Every (Mike Taylor y Dan Shipper). Pasaron 37 documentos por 21 preguntas de escritura de una vez: 777 respuestas en menos de 0,7 segundos por cerca de un cuarto de centavo de dólar. En un test posterior con defectos plantados, Jev omitió 1 de los 7 problemas escondidos; Claude Fable 5.1 los encontró todos. Velocidad confirmada; precisión no perfecta.
JevBench. Un sitio independiente de benchmarks con runs verificables resume la lección más importante: no existe una precisión universal de Jev. Sus runs registrados van del 62,6% al 95,4% según la tarea. En su caso más publicitado — PhishNChips v5.2, clasificar 2.000 emails de phishing (17/09/2026) — Jev logró 62,6% frente al 81,3% de Claude Haiku 4.5. En esa tarea, un LLM chico y barato le gana con claridad.
LangChain/LangSmith. Evaluaron a Jev como juez de agentes y encontraron su punto fuerte más consistente: en scoring continuo, la varianza de Jev fue 92–913 veces menor que la de GPT-5.6 Luna, GPT-5.6 Terra y Claude Sonnet 4.6. Además fue el más rápido y barato del test: 0,44 s y US$0,00035 promedio por llamada (US$0,34 totales contra US$28,17 de Claude en el mismo protocolo). Su conclusión: prometedor, pero temprano.
Aman Kumar. Unos 16.000 llamadas de prueba sobre cuatro datasets públicos de clasificación más decisiones reales de sus pipelines: a nivel o por delante de gpt-5.4-mini y gpt-5.6-luna en tres de cuatro datasets, a un costo entre 5 y 56 veces menor.
La síntesis honesta: velocidad, costo y consistencia confirmados una y otra vez; precisión desigual por tarea. Nadie independiente reprodujo el 200x/400x como promedio universal, pero nadie desmintió la magnitud en los casos puntuales que midió.
Precio: cuánto cuesta y cuándo compensa
El precio de lista es simple: US$0,042 por millón de tokens de entrada, salida gratis. Para calibrar: los LLMs de frontera cuestan entre US$0,20 y US$10 por millón de tokens de entrada, y la salida suele costar ~5 veces más que la entrada.
Dos referencias concretas de lo que esto significa en la práctica:
| Referencia | Número | Fuente y harness |
|---|---|---|
| Demo oficial de Doom jugado por Jev (~10 decisiones/segundo) | ~US$7 por hora de juego | Anuncio de TypeSafe, demo propia |
| Test de juez de agentes: Jev vs Claude en el mismo protocolo | US$0,34 vs US$28,17 | LangChain/LangSmith, test propio de terceros |
El matiz económico que mantengo de la sección anterior: es el precio de un laboratorio en etapa seed que admite abiertamente que no puede demostrar su sostenibilidad. Para decidir adopción, el número relevante no es el precio por token sino el costo por decisión correcta — el mismo criterio que apliqué al análisis de costo por tarea de Gemini 3.8 Flash: un modelo más barato por token puede ser más caro por tarea, y un modelo caro por token puede ganarle el costo total si acierta donde el otro se equivoca.
Cuándo conviene Jev y cuándo no
Con la evidencia acumulada, este es el mapa de decisión que yo usaría:
| Sí, probalo en | No, mantené el LLM en |
|---|---|
| Clasificar, rutear, puntuar, extraer campos: el "if statement inteligente" | Redactar, conversar, generar código: Jev no genera texto, literalmente |
| Guardrails, judges y detección de jailbreak sobre prompts y salidas de un LLM | Tareas de alta precisión donde un LLM grande gana: en phishing (JevBench) perdió 62,6% vs 81,3% de Haiku 4.5 |
| Tiempo real con presupuesto de UX: decisiones en menos de 100 ms | Inputs no textuales: la demo de Doom corre sobre estado textual, no imágenes |
| Map-reduce de decisiones sobre grandes volúmenes de datos | Más de 255 opciones en una sola elección |
| Flujos donde la consistencia importa más que el brillo (scoring continuo) | Integraciones donde un proveedor en etapa seed y early access sea riesgo inaceptable |
Qué mirar antes de adoptarlo
Si el mapa de arriba te deja dentro, mi checklist antes de meterlo en producción:
- Definí la decisión, no la conversación. Jev entra donde hay una pregunta tipada con respuestas definibles. Si no podés escribir esa pregunta, no es tu herramienta.
- Evaluá en tus datos y con tu esquema. La dispersión de JevBench (62,6%–95,4%) es la prueba de que ningún número público decide por vos.
- Exigí calibración medible. La promesa es que la confianza correlacione con precisión; graficalo con tus propios casos antes de confiar en un umbral.
- Contá el costo por decisión correcta, no por token, y compará contra el LLM más barato que ya usás para eso.
- Usá el adapter como caballo de Troya de evaluación: el adapter System One permite correr un LLM con la misma interfaz y comparar manzanas con manzanas.
- Ponderá el riesgo de proveedor: laboratorio nuevo, ronda seed, early access por waitlist, sin GA anunciada al cierre de este artículo.
El veredicto
Como categoría, Jev es la primera apuesta seria de modelos para software, no para personas, y su aporte conceptual más valioso no es el 200x: es la separación entre salida válida y respuesta correcta, con la calibración como contrato. Si esa idea se consolida, va a cambiar cómo se conectan los modelos con el código — probablemente dentro de los harnesses de agentes como piezas de verificación y decisión, no como reemplazo del modelo que razona.
Como decisión de adopción hoy: probalo en puntos de decisión de alto volumen y baja ambigüedad semántica, y mantené el LLM donde el juicio importa. No lo adoptes por el titular; adoptalo si en tu tarea gana o empata a una fracción del costo — para eso está el waitlist y su playground.
Lo que voy a seguir mirando: la salida a disponibilidad general, un paper de RLCD que permita auditar el método de entrenamiento, y la extensión a más modalidades de entrada. Cualquiera de las tres puede actualizar este análisis.
Preguntas frecuentes
¿Qué es Jev y quién lo creó?
Jev es el primer modelo System One de TypeSafe AI, laboratorio de San Francisco fundado por Diogo Almeida (ex-OpenAI, ex-Google Brain; su bio oficial dice co-inventor de RLHF e InstructGPT). Se lanzó el 15 de septiembre de 2026 en early access, con US$40 millones de ronda seed liderada por DCVC.
¿Por qué dicen que Jev no alucina?
Porque su salida siempre es un valor válido del esquema definido de antemano: no puede generar texto de más, formato roto ni campos inexistentes. Eso elimina errores de tipo, no errores de juicio: la corrección de cada respuesta sigue siendo probabilística y se verifica con la calibración de sus probabilidades.
¿Cuánto cuesta Jev?
US$0,042 por millón de tokens de entrada; los tokens de salida son gratis. En el test independiente de LangChain promedió US$0,00035 por llamada. El propio TypeSafe advierte que no puede probar que el precio no esté subsidiado a esta altura.
¿Jev reemplaza a ChatGPT o a Claude?
No. No conversa ni redacta: compite en puntos de decisión (clasificar, rutear, puntuar, verificar). Las pruebas independientes muestran precisión desigual por tarea — con casos donde pierde frente a LLMs chicos — así que el marco correcto es complementariedad, no reemplazo.
¿Cuándo se puede usar Jev?
Está en early access por waitlist desde el 15 de septiembre de 2026. No hay fecha de disponibilidad general anunciada; la consola y la documentación están en console.typesafe.ai y docs.typesafe.ai.
Fuentes
| Fuente | Qué respalda |
|---|---|
| TypeSafe AI — anuncio de Jev | Mecánica, RLCD, precio, latencia, metodología de workflow evals, matices del vendor (15-sep-2026) |
| TypeSafe AI — equipo | Bio de Diogo Almeida: RLHF, InstructGPT, Google Brain |
| Business Wire — comunicado de lanzamiento | US$40M seed, salida de stealth (15-sep-2026) |
| Forbes — The Prompt | Valuación ~US$200M "según una persona familiarizada", ejemplo de underwriting (15-sep-2026) |
| TechCrunch | Contexto de Almeida en OpenAI, recepción de developers (18-sep-2026) |
| Every — Mini-Vibe Check | 777 juicios en 0,7 s; test de defectos plantados vs Fable 5.1 |
| JevBench | Precisión 62,6%–95,4% según tarea; PhishNChips v5.2: Jev 62,6% vs Haiku 4.5 81,3% |
| LangChain — Jev agent evals | Varianza 92–913x menor, US$0,34 vs US$28,17, "prometedor pero temprano" |
| Aman Kumar — Jev measured | ~16.000 llamadas; 3 de 4 datasets a nivel o encima de mini models, 5–56x más barato |
| GitHub — system-one-adapter-python | Adapter oficial para comparar LLMs con la misma interfaz |
| TypeSafe AI — workflow evals | Detalle de workflows, desacuerdos y consultas completas |

Especialista en Agentes de IA · Copenhague
Diseño e implemento agentes IA, MCP servers y harnesses en producción: el loop, las herramientas y el contexto que hacen que un modelo pase de contestar a trabajar. Todo lo que ves en este sitio está construido así.
Artículos relacionados
Claude Buddy: Guía Completa del Tamagotchi de Claude Code (18 Especies y Rarezas)
Claude Buddy: las 18 especies, 5 rarezas, comandos /buddy y cómo conseguir un Shiny Legendary (0.01% de probabilidad). Guía completa en español.
¿La IA nos va a matar? Miedo, intereses y qué hay de real
El pánico por la IA mezcla riesgos operativos reales, intereses comerciales que viven del FOMO y una carrera geopolítica. Un análisis racional con fuentes.
Inteligencia Artificial para PyMEs: Por Dónde Empezar en 2026 (Guía Práctica)
IA para PyMEs: por dónde empezar, qué herramientas usar, cuánto cuesta y qué esperar. Sin tecnicismos. Con plan de acción de 30 días.