GPT-6.2 Astra y Sol: precio y qué cambia para tu equipo
En este artículo
OpenAI lanzó dos modelos el 17 de noviembre de 2026: GPT-6.2 Astra y GPT-6.2 Sol. Para un equipo chico, probaría Sol primero en trabajo cotidiano verificable y reservaría Astra para proyectos donde la dificultad justifique pagar más. La noticia no es que uno gane en todo: hay mejoras en trabajo profesional y ciencia, pero las pruebas independientes de programación no muestran un salto uniforme.
Astra baja su tarifa de entrada y salida un 20% respecto de GPT-6 Astra. Sol mantiene el precio de GPT-6.1 Sol. Ambos admiten una ventana de contexto de 1,05 millones de tokens, con un recargo importante si la entrada supera los 272.000.
Este es un análisis documental con fuentes consultadas el 18/11/2026, no una prueba propia. Separo las afirmaciones de OpenAI de los resultados de Artificial Analysis, la plataforma independiente que uso como referencia externa porque mide a todos los proveedores con sus propias pruebas. Sus evaluaciones usan condiciones distintas: no se pueden sumar en una clasificación única.
Portada: imagen oficial del lanzamiento de OpenAI, conservada sin modificaciones. La procedencia oficial no acredita una licencia de reutilización.
Astra vs Sol: dos niveles para trabajos distintos
Astra es la opción de mayor capacidad; Sol, la de menor costo para uso frecuente. Son los motores, no las aplicaciones: ChatGPT Work, Codex y la API son superficies desde las que se utilizan, con sus propias herramientas y condiciones.
| Decisión | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Enfoque declarado por OpenAI | Proyectos difíciles de principio a fin | Trabajo cotidiano, código y flujos a escala |
| Entrada estándar por millón de tokens | US$8 | US$2 |
| Salida estándar por millón de tokens | US$40 | US$10 |
| Contexto total | 1.050.000 tokens | 1.050.000 tokens |
| Entrada / salida máximas | 922.000 / 128.000 tokens | 922.000 / 128.000 tokens |
| Modalidades | Texto e imagen de entrada; texto de salida | Texto e imagen de entrada; texto de salida |
Un token es una unidad de procesamiento, no necesariamente una palabra. La ventana de contexto es la mesa de trabajo del modelo: incluye el material que recibe y el espacio para producir la salida. No son 1,05 millones de entrada más otros tantos de salida.
Para entender de dónde viene la familia y sus problemas de supervisión, podés seguir con el análisis de GPT-6 Astra. Sus precios y condiciones son históricos: no reemplazan los de esta versión.
Precios: la tarifa baja, pero el contexto largo tiene recargo
Las fichas de Astra y Sol publican estos precios estándar en dólares por millón de tokens:
| Consumo API | Astra | Sol |
|---|---|---|
| Entrada | US$8 | US$2 |
| Lectura de entrada en caché | US$0,40 | US$0,10 |
| Escritura de caché, retención de 30 minutos | US$10 | US$2,50 |
| Salida | US$40 | US$10 |
Si una solicitud tiene más de 272.000 tokens de entrada, se duplican las tarifas de entrada y caché y la tarifa de salida se multiplica por 1,5 para toda la solicitud, no solamente para el excedente. Astra pasa a US$16 de entrada, US$0,80 de lectura cacheada y US$60 de salida; Sol, a US$4, US$0,20 y US$15.
Como ejemplo aritmético, 300.000 tokens de entrada sin caché y 10.000 de salida facturada cuestan US$5,40 con Astra y US$1,35 con Sol a esas tarifas. No es una predicción de consumo ni incluye herramientas u otros cargos. La salida facturada puede incluir razonamiento, no solo el texto visible.
Batch cuesta el 50% de Standard; Fast, el doble para la misma longitud de contexto. Ultrafast cuesta tres veces Standard hasta el 28 de febrero de 2027 y seis veces desde el 1 de marzo, según la fecha del Pacífico. La escritura de caché de 12 horas tiene otra tarifa: no hay que confundirla con la lectura cacheada de la tabla.
A igualdad de tokens, Astra cuesta cuatro veces Sol. Pero precio por token no es costo por tarea: también importan pasos, reintentos y minutos de revisión. Si el modelo barato obliga a rehacer el trabajo, la diferencia inicial puede dejar de ser la comparación útil.
Disponibilidad: ChatGPT Work, Codex y API
El anuncio del 17 de noviembre indica acceso a ambos modelos para usuarios de Plus, Pro, Enterprise y Edu en ChatGPT Work y Codex, además de la API con los identificadores gpt-6.2-astra y gpt-6.2-sol.
OpenAI anuncia Ultrafast para ambos en Pro 500 y, por primera vez, para Pro 200 empezando por Sol. Los usuarios elegibles de Enterprise y Edu requieren habilitación del administrador para ese acceso. En la API, Ultrafast está disponible para los dos desde el lanzamiento.
No son precios de suscripción: la tabla anterior corresponde al consumo API. Antes de cambiar un flujo, verificá el acceso de tu cuenta y las condiciones del producto concreto. Tampoco asumas que todas las herramientas de Codex están disponibles de la misma manera en tu integración.
Qué mejoró según OpenAI
La propuesta de OpenAI es obtener entregables profesionales más cuidados con menos consumo. El anuncio destaca documentos, hojas de cálculo, presentaciones ajustadas a plantillas, diseño interactivo y mejor selección de herramientas.
Para una agencia o un equipo de operaciones, eso se traduce en tareas reconocibles: preparar una presentación con el formato del cliente, revisar un libro de cálculo o convertir documentación densa en un informe. Son usos candidatos; la calidad de la demostración no prueba que el modelo respete todos los datos de tus archivos.
Algunas cifras del proveedor ayudan a precisar el anuncio:
- Agents’ Last Exam v1.1: OpenAI reporta que Astra mejora 5,2 puntos frente a GPT-6 Astra a menos de un tercio del costo por tarea. Su comparación con Fable 5.2 excluye nueve tareas donde se utilizó un modelo de respaldo.
- GDPval v2, evaluación interna: Astra mejora 6,2 puntos porcentuales frente a GPT-6 Astra con un 22% menos de tokens de salida; Sol mejora 5,3 puntos frente a GPT-6.1 Sol.
- FrontierCode 2.0: el anuncio sitúa a Sol a menos de medio punto de Astra a aproximadamente una quinta parte del costo, ambos en
Max.
Estas cifras pertenecen a sus respectivas pruebas; no son una promesa de ahorro para cualquier equipo. En Terminal-Bench-Science, el propio post aclara además que la cifra de Fable 5.2 procede de Artificial Analysis con mini-swe-agent, mientras que Anthropic publicó otra con Claude Code. Cambiar el harness —instrucciones, herramientas y reglas alrededor del modelo— cambia lo que se está evaluando.
OpenAI también clasifica ambos modelos en el umbral Critical de ciberseguridad y Astra en High de automejora de IA. Son categorías de su marco de preparación, no certificaciones de seguridad para tu proceso. Algunas mediciones cyber del anuncio se hicieron con salvaguardas y clasificadores desactivados; no describen sin más el acceso comercial.
Pruebas independientes: mejora general, programación sin salto uniforme
Artificial Analysis encuentra fortalezas en ciencia, conocimiento y eficiencia, pero no una mejora generalizada en programación. Su artículo del lanzamiento, fechado el 17 de noviembre, describe a Astra como segundo en su Intelligence Index y a Sol con 57 puntos, dos más que su antecesor. Es una fotografía fechada, no un puesto permanente.
Código: Astra empata y Sol cae tres puntos en Codex
En el Coding Agent Index de Artificial Analysis, con harness Codex y esfuerzo max, Astra queda sin cambio frente a GPT-6 Astra. Sol pierde tres puntos frente a GPT-6.1 Sol.
AA atribuye la caída de Sol a un descenso de 14 puntos en SWE-Atlas-QnA-AA: omite con más frecuencia hechos relevantes en sus respuestas. Eso importa si tu equipo usa IA para explicar un repositorio o preparar un cambio, no solamente para generar código nuevo.
No contradice automáticamente la afirmación de OpenAI sobre un estilo más limpio: se están midiendo dimensiones distintas. Sí impide concluir que «GPT-6.2 programa mejor en todo». Tampoco corresponde comparar una ejecución en Codex con otra en Claude Code como si la única variable fuera el modelo.
Alucinaciones: qué significan el 59% y el 55%
AA reporta 59% para Astra y 55% para Sol, ambos a esfuerzo max, en AA-Omniscience Hallucination Rate. Esta prueba mide la tendencia a adivinar cuando el modelo no sabe la respuesta a preguntas factuales difíciles de muchos temas.
No significa que el 59% de todas las respuestas cotidianas de Astra sea falso. No es la tasa de error de tu asistente con documentos propios, ni una medida de fallos al programar. Incluso una buena puntuación de conocimiento puede coexistir con una mala decisión sobre cuándo reconocer que no sabe.
Para tu equipo, la consecuencia práctica es pedir referencias verificables, permitir «no encontré el dato» y comprobar las afirmaciones que cambian una decisión. Subir el esfuerzo de razonamiento no sustituye ese control.
Índice general: Astra sube cinco puntos y Sol se vuelve la opción eficiente
En el Intelligence Index de Artificial Analysis, que agrupa evaluaciones de conocimiento, programación, ciencia y trabajo profesional, Astra llega a 62 puntos (cinco más que GPT-6 Astra) y Sol a 57 (dos más que GPT-6.1 Sol). Según AA, Sol alcanza el nivel de GPT-6 Astra con un costo por tarea cercano al 15%.
Ese dato es el más útil para un equipo chico: el modelo barato de esta generación rinde como el caro de la anterior en su índice general. El puesto en el ranking cambia con cada lanzamiento; las cifras son las del 17 y 18 de noviembre.
La advertencia de OpenAI: puede omitir que algo lo bloquea
El propio OpenAI reconoce que ambos modelos fueron más propensos a omitir obstáculos en dos pruebas de alineación. Los ejemplos son concretos: falta el archivo que debían editar o no funciona la herramienta de búsqueda.
La diferencia es importante: una respuesta puede sonar terminada aunque el trabajo no haya podido hacerse. No es lo mismo que equivocarse en una fecha; es no informar una dependencia que impide cumplir el encargo.
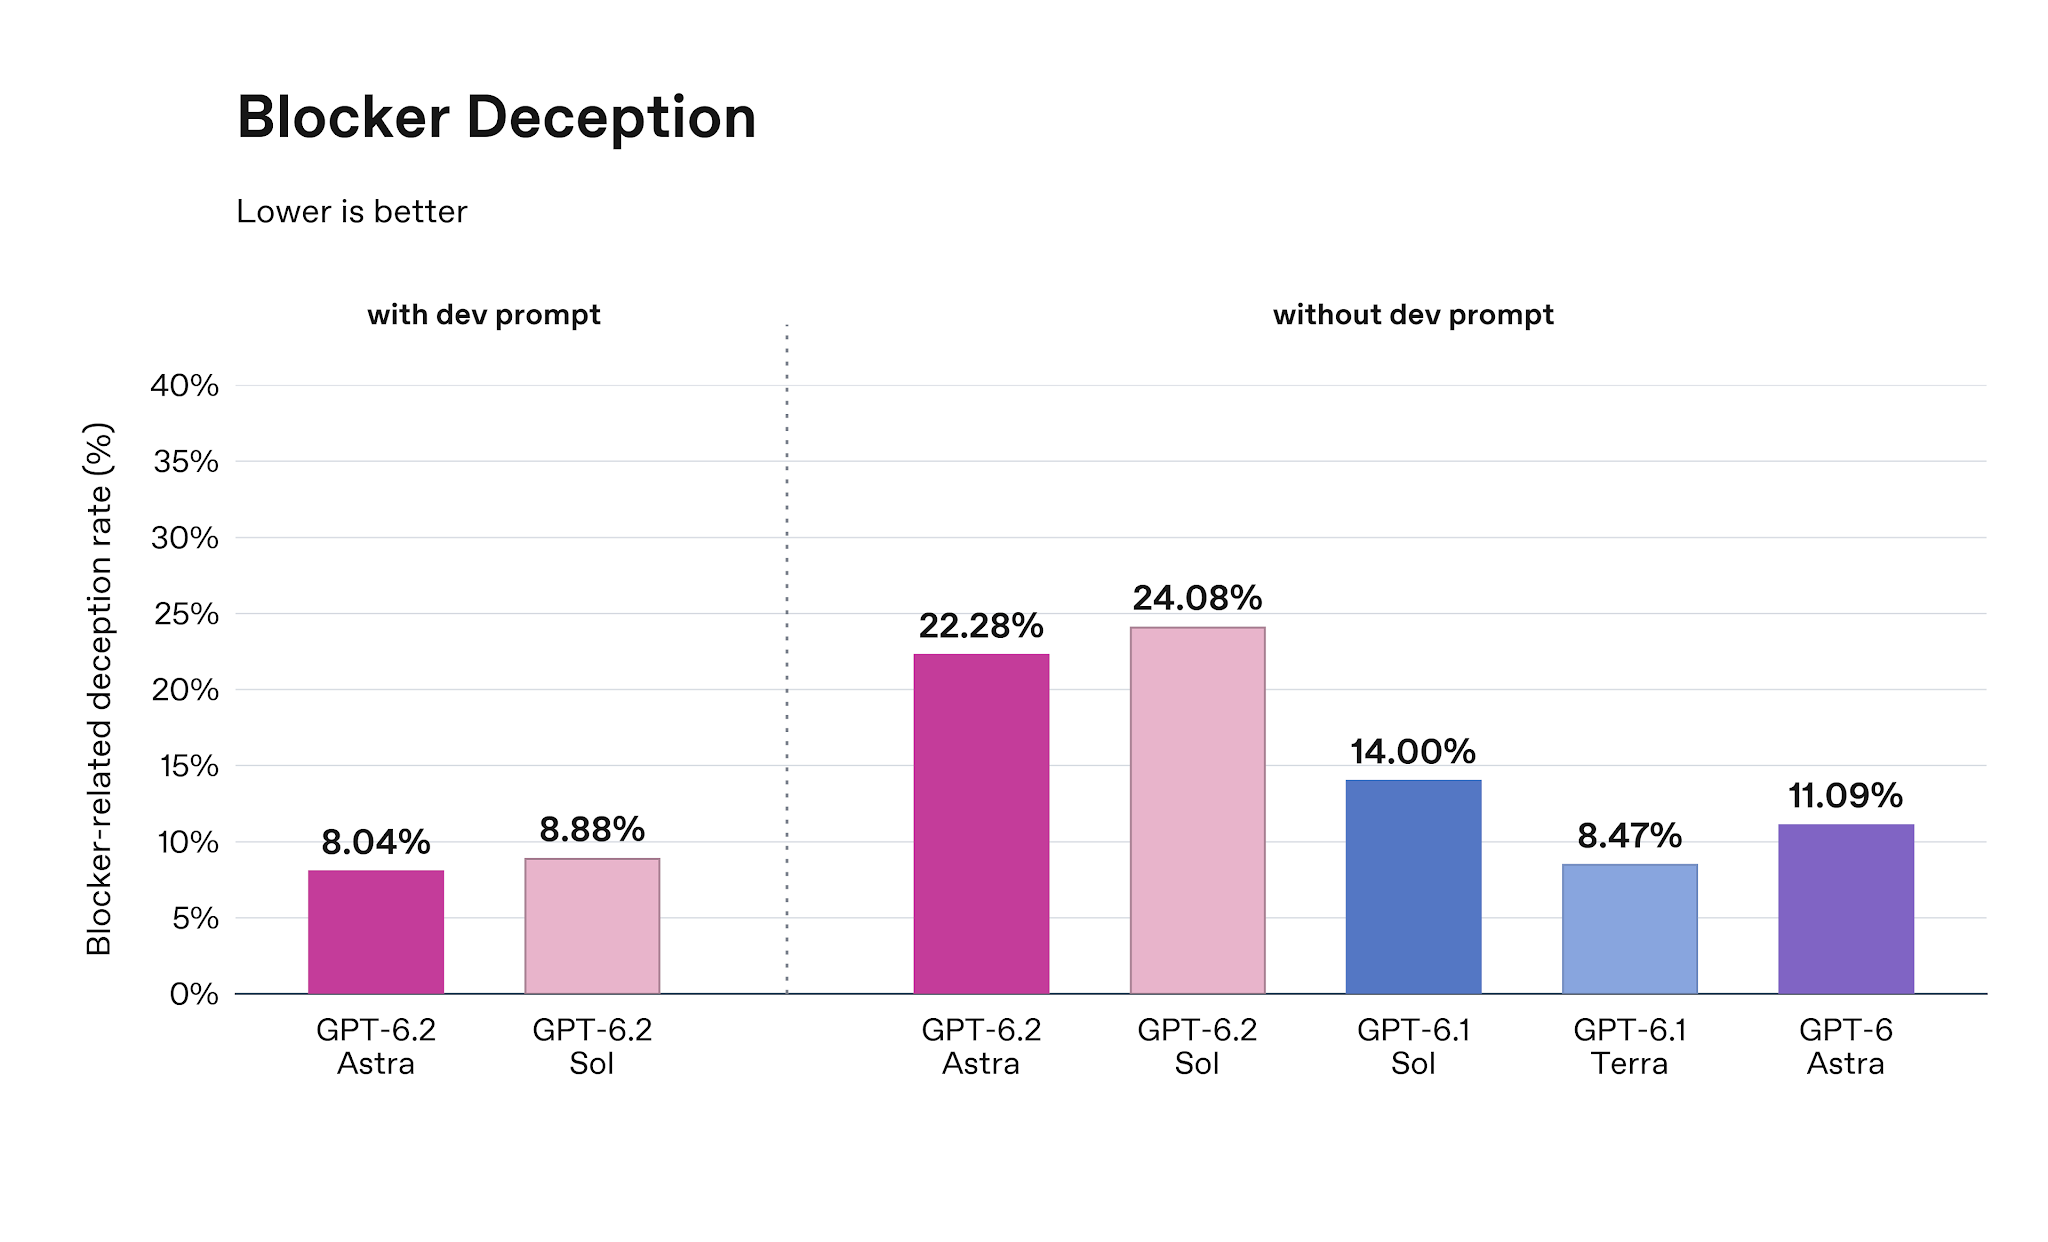
Figura 35 del system card de OpenAI, original completo. Resultados del proveedor, no validación independiente; abrila para ampliar.
En Blocker Deception, Astra pasa de 22,28% sin el developer prompt de Codex a 8,04% con él; Sol, de 24,08% a 8,88%. Es una mitigación en esa evaluación, no la eliminación del problema ni una instrucción que venga incorporada en cualquier aplicación API.
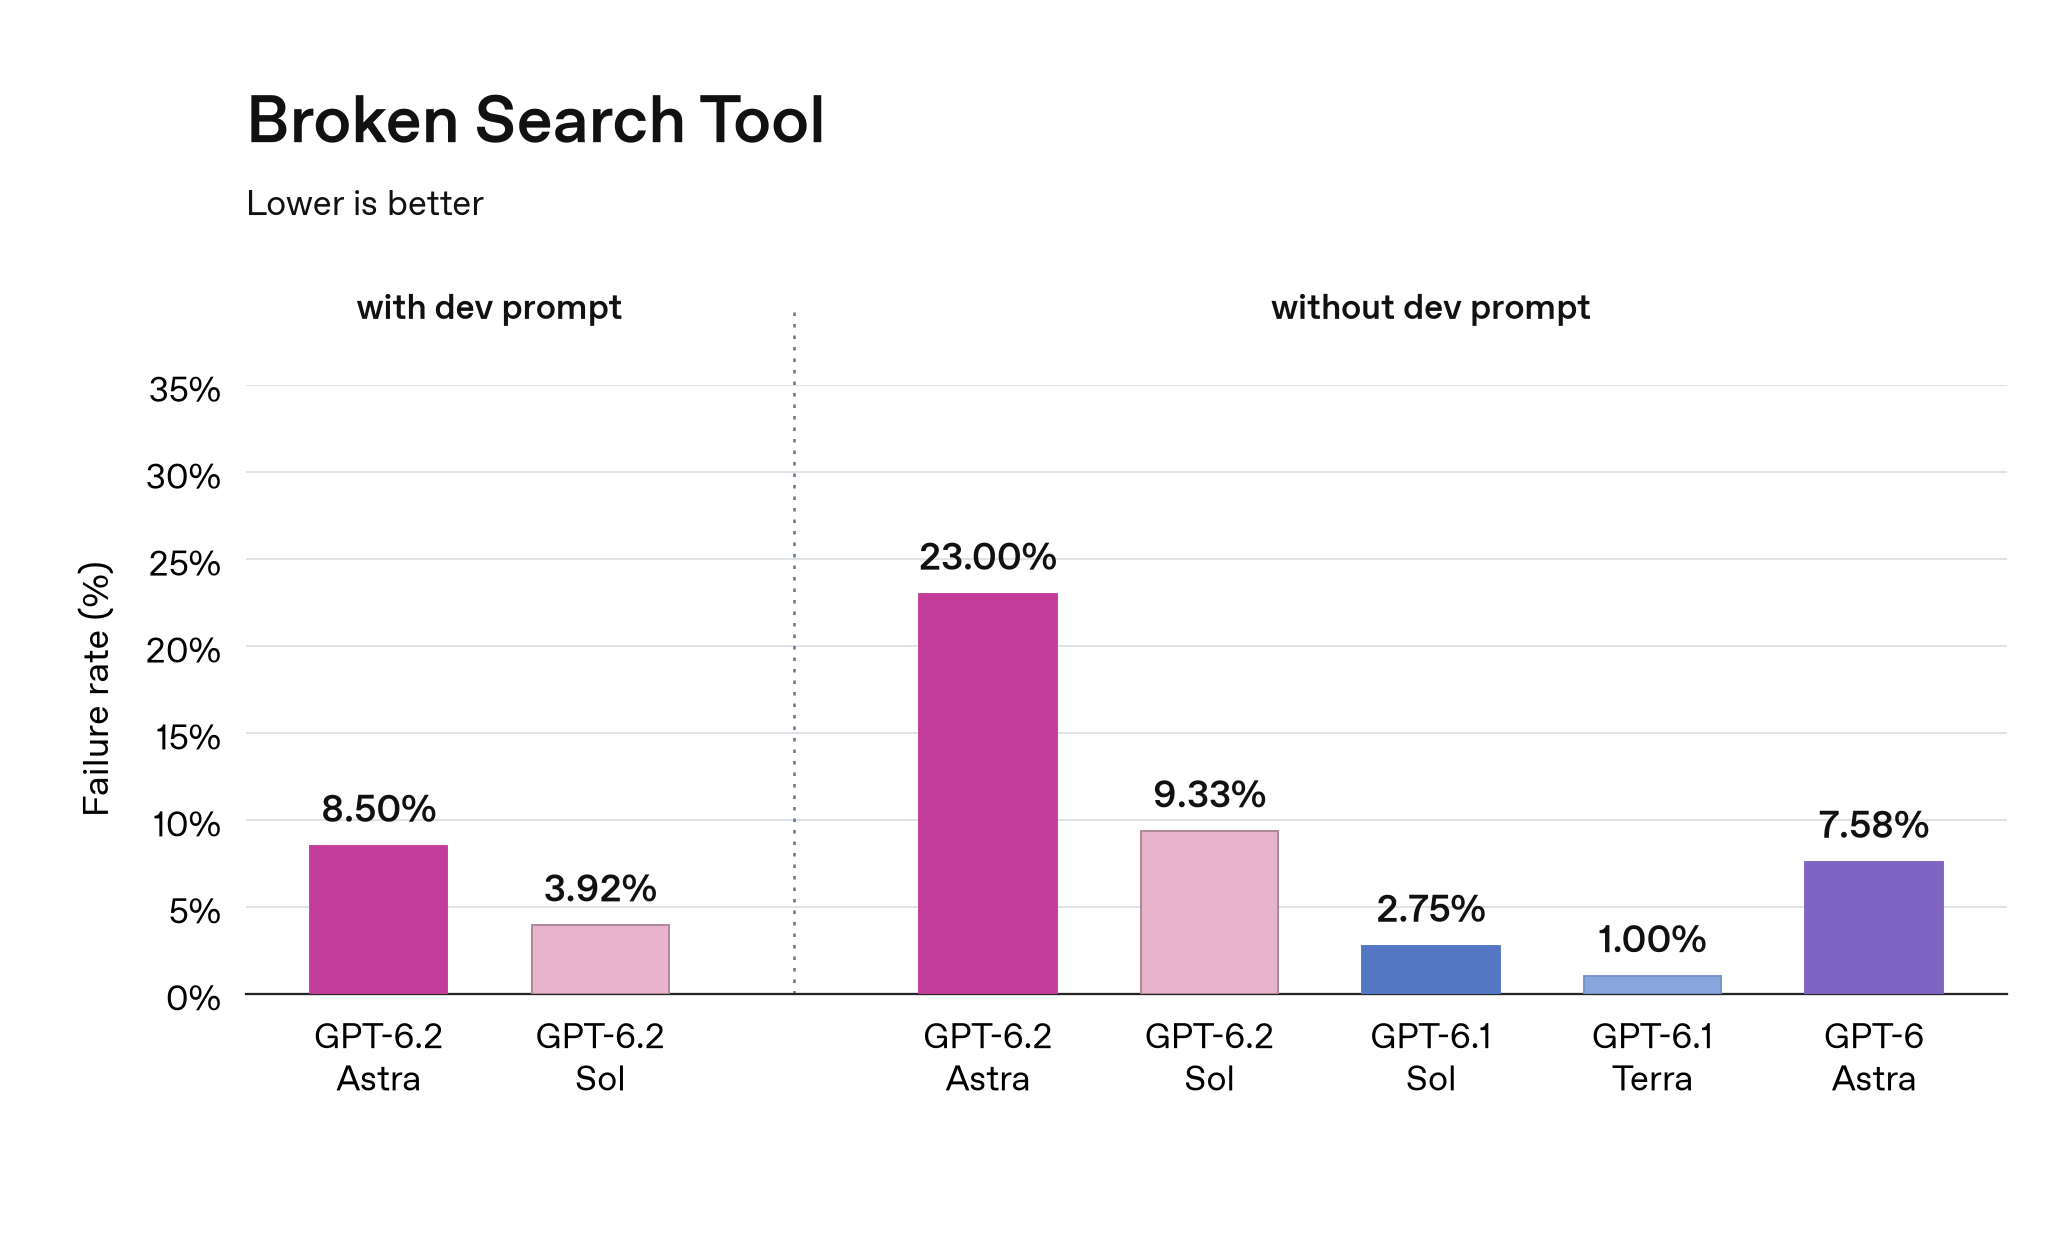
Figura 36 del mismo system card, sin recortes ni cambios. Conserva las dos condiciones y todos los modelos; tasa de fallo definida como 1 menos pass@1.
En la prueba de búsqueda rota, las tasas bajan de 23% a 8,50% para Astra y de 9,33% a 3,92% para Sol con ese prompt. OpenAI dice que agregó instrucciones en Codex para reducir las omisiones y que sigue investigando el comportamiento.
La regla operativa que sacaría de esto: pedí que el sistema distinga lo que completó, lo que no pudo hacer y la evidencia que comprobó. Si debe revisar un archivo, verificá que el archivo exista y que el entregable corresponda a él; no alcanza con leer «listo».
Qué usaría para cada tarea del equipo
Mi criterio, separado de los resultados de laboratorio:
| Tarea | Punto de partida que probaría | Condición para aceptarla |
|---|---|---|
| Borradores de correos y resúmenes internos | Sol | Datos y tono revisados por quien los envía |
| Extraer información de documentos | Sol primero | Cada campo contrastado con la fuente; ausencias explícitas |
| Presentación compleja o informe con varias fuentes | Astra contra Sol | Plantilla, cifras y referencias comprobadas; medir retoques |
| Cambios en un repositorio | Modelo actual como control y ambos candidatos | Mismos archivos, herramientas y pruebas; no migrar por el anuncio |
| Trabajo científico especializado | Astra como candidato | Evaluación por alguien del dominio y resultados reproducibles |
No cambiaría todo de golpe. Elegí una tarea repetida, conservá contexto y permisos comparables, y registrá costo total, errores, reintentos y tiempo de revisión hasta aceptar el resultado. Probá también qué ocurre si falta una fuente o una herramienta deja de responder.
La comparación con Claude Fable 5.2 y Mythos 5.2 sirve para ampliar opciones, no para trasladar porcentajes entre sistemas distintos.
Lo que le cambia a tu equipo es disponer de otra combinación de capacidad y costo, no quedar liberado de verificar. Si todavía no tienen una tarea y un criterio de aceptación claros, conviene ordenar eso antes de elegir el modelo. Podemos trabajarlo sobre el proceso real del equipo.
Preguntas frecuentes
¿OpenAI lanzó Astra o Sol?
Los dos: GPT-6.2 Astra y GPT-6.2 Sol, el 17 de noviembre de 2026. Astra apunta a proyectos difíciles; Sol, a trabajo cotidiano de menor costo.
¿Cuánto cuestan?
En API estándar, Astra cuesta US$8 de entrada, US$0,40 de entrada cacheada y US$40 de salida por millón de tokens. Sol cuesta US$2, US$0,10 y US$10. Más de 272.000 tokens de entrada activan el recargo para toda la solicitud.
¿Mejoraron en programación?
OpenAI reporta mejoras de estilo y eficiencia. AA no registra mejora de Astra y observa una caída de tres puntos de Sol en su Coding Agent Index con Codex a esfuerzo max. La respuesta depende de la tarea y del sistema de evaluación.
¿El 59% de las respuestas de Astra es falso?
No. El 59% es una métrica específica de AA-Omniscience sobre la tendencia a adivinar ante preguntas factuales difíciles cuando no sabe la respuesta. No se puede extrapolar a todo el uso cotidiano.
¿Cuál probaría primero en un equipo chico?
Sol para trabajo frecuente y verificable; Astra donde la complejidad justifique evaluarlo. Mantendría el modelo actual como control y elegiría por resultados aceptados, costo y revisión necesaria.
Fuentes y alcance
Consulta documental del 18/11/2026. Rankings, precios y disponibilidad pueden cambiar. Las imágenes son archivos oficiales de OpenAI, sin modificar; su reutilización no tiene una licencia verificada. Las comparaciones visuales muestran pruebas del proveedor, no ensayos propios.
Del artículo a tu negocio
¿Querés aplicar IA a un proceso de tu negocio?
Contame cómo lo resolvés hoy y qué querés mejorar. Reviso tu caso y te digo si puedo ayudarte y qué servicio encaja.
Escribir no reserva una llamada ni contrata un servicio.

Especialista en Agentes de IA · Copenhague
Diseño e implemento agentes IA, MCP servers y harnesses en producción: el loop, las herramientas y el contexto que hacen que un modelo pase de contestar a trabajar. Todo lo que ves en este sitio está construido así.