Claude Fable 5.2 y Mythos 5.2: qué cambia, precio y acceso
En este artículo
Claude Fable 5.2 y Claude Mythos 5.2 se lanzaron el 9 de noviembre de 2026. Son el mismo modelo subyacente, con distintas salvaguardas y condiciones de acceso. La tarifa API baja a US$8 por millón de tokens de entrada y US$40 de salida, pero Anthropic sigue recomendando empezar con Opus 5.5 para la mayoría del trabajo.
El anuncio oficial de Anthropic reporta mejoras en programación, razonamiento y visión. La decisión útil no es cambiar todo por la versión nueva: es comprobar si resuelve tareas difíciles que tu modelo actual no completa con calidad aceptable.
Este es un análisis documental, no una prueba propia. Las capacidades y resultados siguientes son afirmaciones del proveedor; precio, acceso y compatibilidad corresponden a la documentación consultada el día del lanzamiento.
Fable y Mythos: misma capacidad base, distinto acceso
Fable 5.2 incorpora salvaguardas fuertes para ciberseguridad y biología que permiten su disponibilidad general. Mythos 5.2 ofrece las mismas capacidades a organizaciones verificadas para trabajar en esas áreas de doble uso.
| Aspecto | Fable 5.2 | Mythos 5.2 |
|---|---|---|
| ID en Claude API | claude-fable-5-2 | claude-mythos-5-2 |
| Contexto / salida máxima | 1M / 128K tokens | Igual |
| Precio API base | US$8 entrada / US$40 salida por MTok | Igual |
| Acceso | General, sujeto a plataforma y cuenta | Programas de verificación |
| Diferencia práctica | Clasificadores de seguridad más restrictivos | Acceso autorizado para usos especializados |
MTok significa un millón de tokens: unidades de procesamiento del texto, no palabras. Compartir modelo no significa obtener siempre la misma respuesta: una petición puede quedar bloqueada por las salvaguardas de Fable.
Anthropic informa menos bloqueos innecesarios que en 5.1, pero advierte que Fable continúa bloqueando la mayoría de las tareas relacionadas con ciberseguridad y muchas de investigación biológica. Para Mythos se solicita acceso mediante los programas Cyber o Life Sciences; postularse no equivale a tenerlo habilitado.
Qué capacidades nuevas merecen una evaluación
El salto que describe Anthropic combina mejor resolución técnica, lectura visual y continuidad en tareas largas. Tres ejemplos ayudan a entender el alcance sin convertir una demostración en garantía.
Programación con ambigüedad. Anthropic cuenta que una versión previa de Fable 5.2 ayudó a migrar un servicio de producción de Python a Rust. También describe un experimento que produjo un sistema operativo funcional tras ocho días de trabajo coordinado. Son experiencias internas con infraestructura y revisión, no evidencia de que cualquier repositorio pueda migrarse sin supervisión.
Lectura de gráficos. En Chartography, sin herramientas, Anthropic reporta 73,4% para Fable 5.2 frente a 44,8% para Fable 5.1, con el mayor esfuerzo disponible salvo las excepciones rotuladas. Para un equipo que analiza informes, la hipótesis útil es comprobar si interpreta mejor ejes, unidades y relaciones; no asumir que deja de cometer errores numéricos.
Ingeniería y ciencia. El anuncio describe tres dispositivos electrónicos diseñados con Fable y fabricados por Diode, y la formalización de la demostración del último teorema de Fermat en Lean. Formalizar significa traducir una prueba para verificarla por computadora: no descubrir por primera vez el teorema. El experimento usó alrededor de mil agentes y una sola ejecución por modelo.
Estos ejemplos justifican investigar tareas antes poco viables. No demuestran autonomía general ni sustituyen controles humanos, recursos de cómputo o validación especializada.
La comparativa oficial y sus límites
Esta es la comparación publicada por Anthropic, no un ranking independiente:
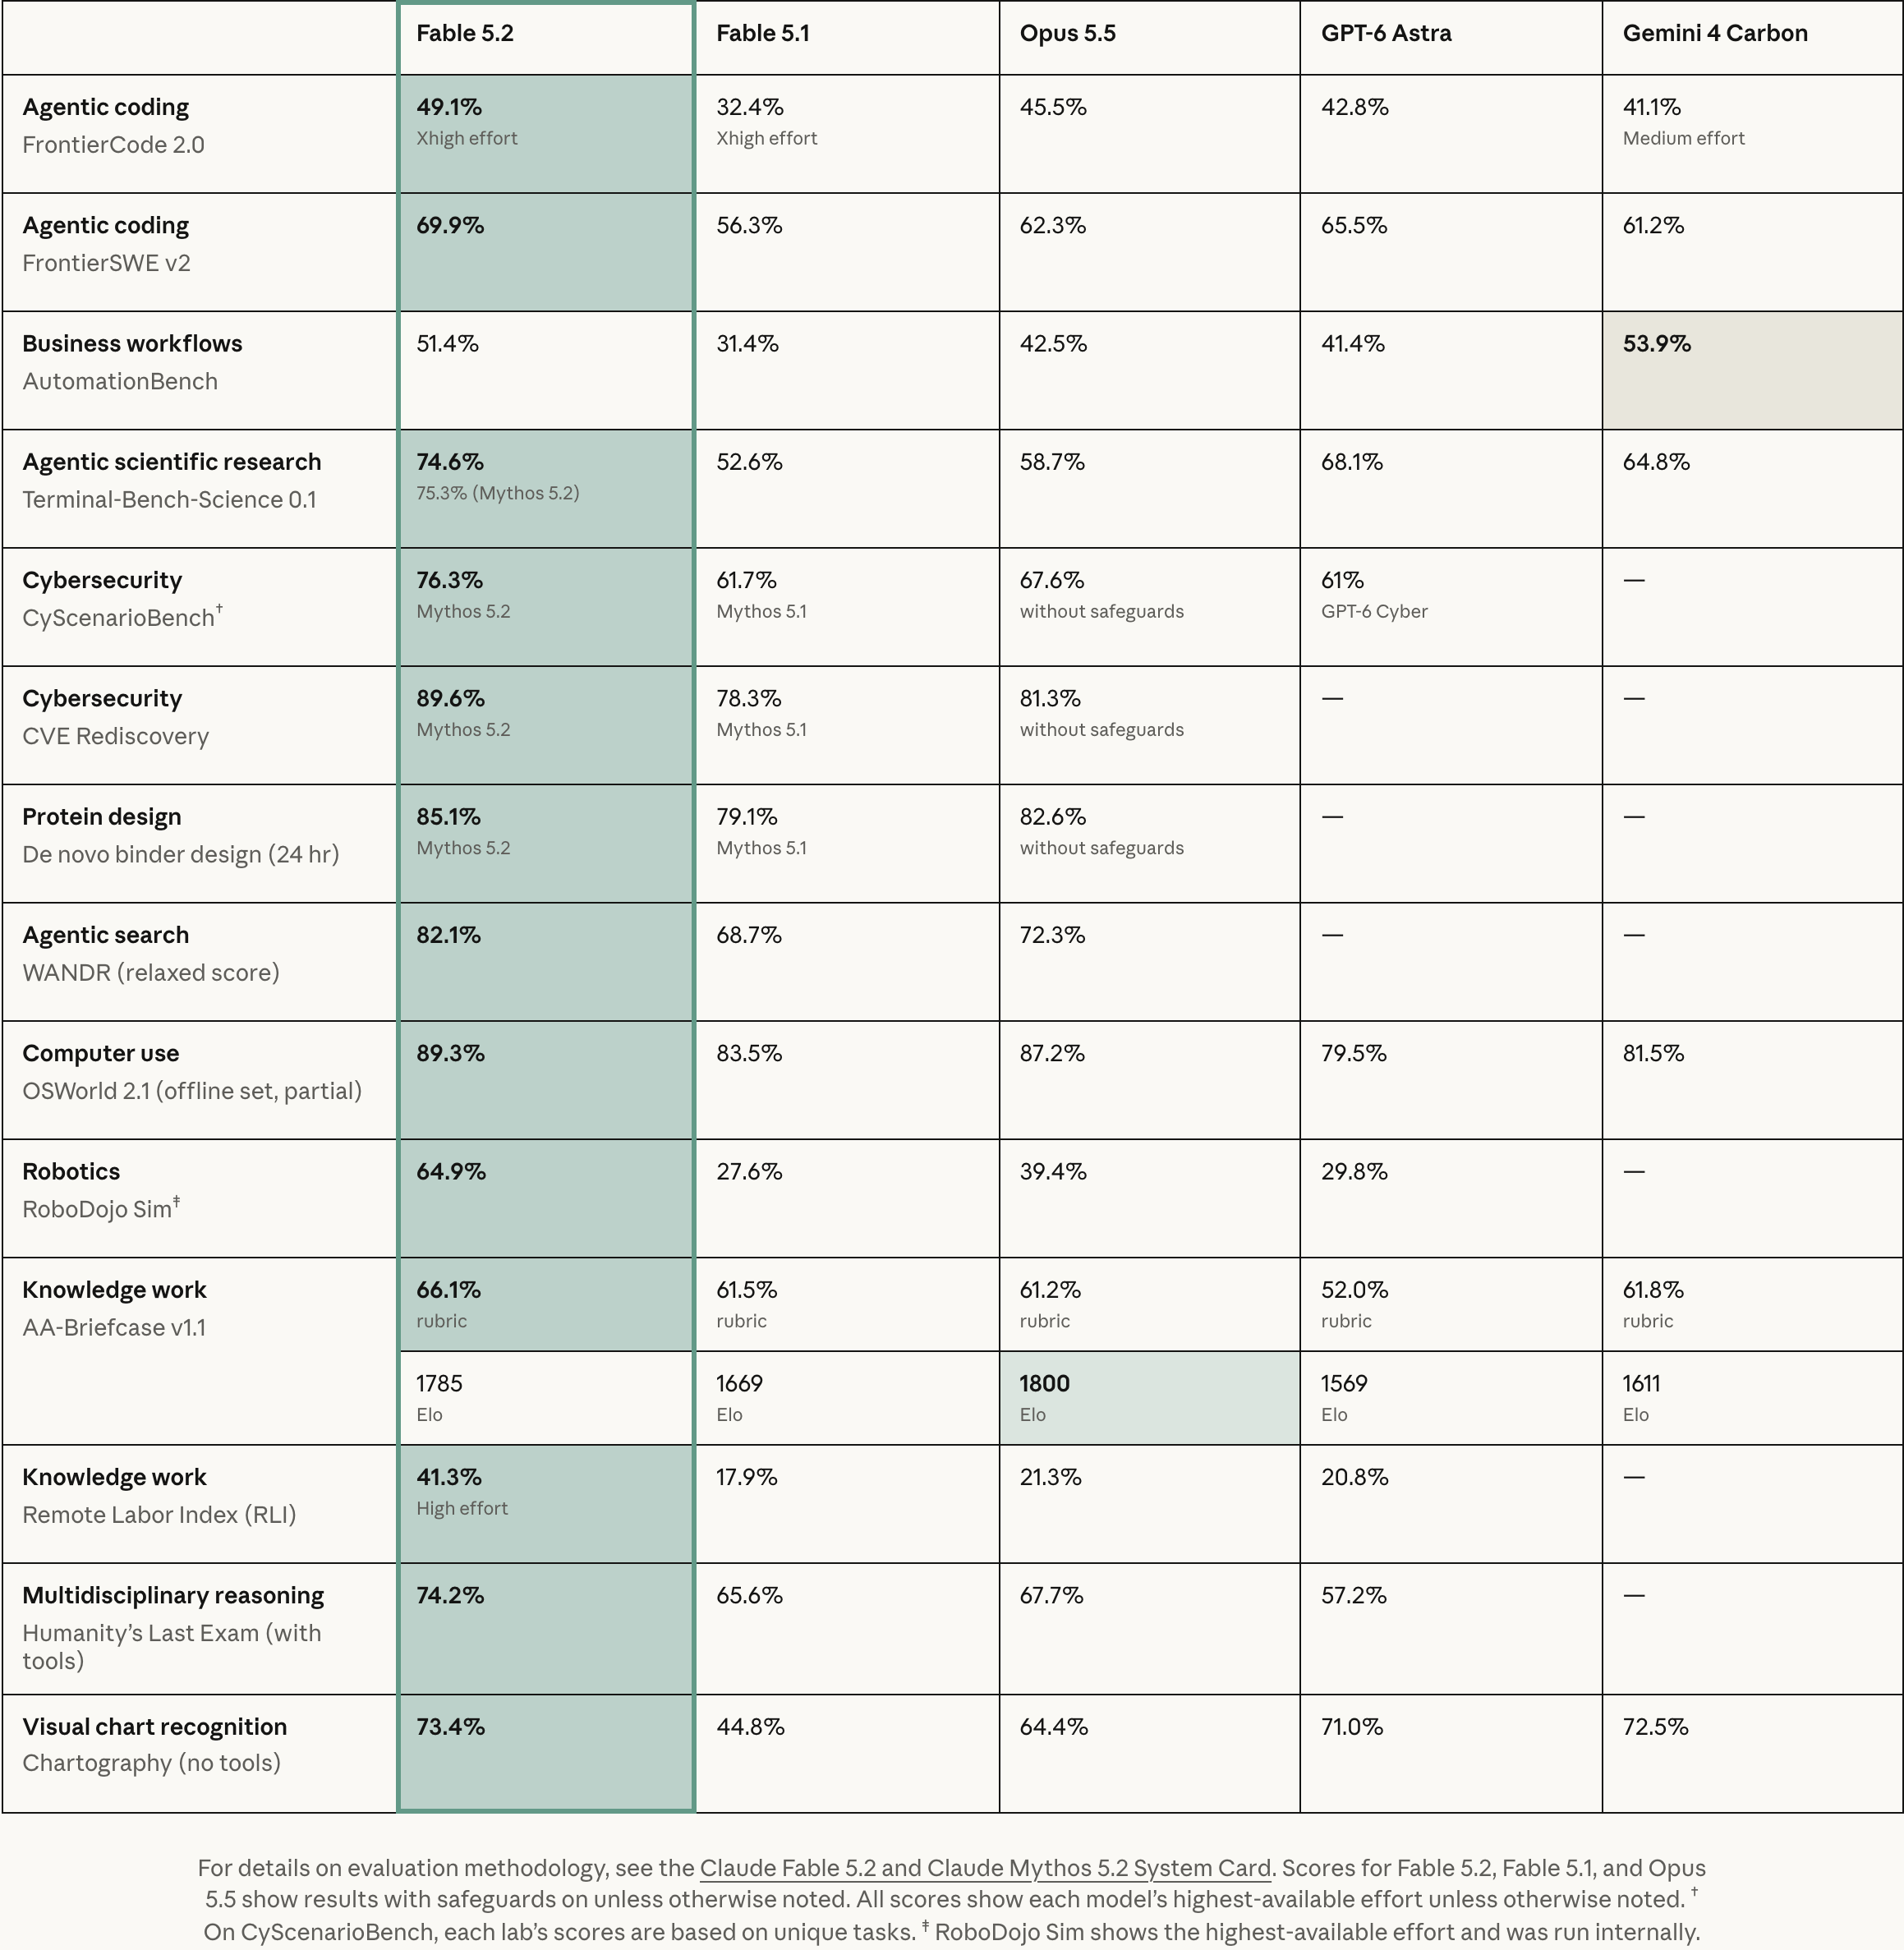
Fuente: Anthropic, anuncio de Fable 5.2 y Mythos 5.2. Resultados reportados por Anthropic. Se usa el mayor esfuerzo disponible salvo indicación; algunas filas señalan otro esfuerzo o modelos sin salvaguardas. CyScenarioBench usa tareas únicas por laboratorio; RoboDojo Sim se ejecutó internamente. Esas condiciones impiden inferir un ganador universal entre proveedores.
Abrí la comparativa completa en su resolución original (2318 × 2374) para ampliar las celdas en móvil.
Como complemento accesible, estas tres filas transcriben los porcentajes de la misma fuente, en el mismo orden de modelos. Se usa el mayor esfuerzo disponible salvo indicación en el original; Chartography se evaluó sin herramientas. Esta selección no reemplaza la imagen completa ni sus notas metodológicas.
| Evaluación | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Chartography (no tools) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
La tabla tampoco dice que Fable gane en todo: en AA-Briefcase, por ejemplo, la evaluación por rúbrica y Elo son medidas distintas. Conviene leer la fila pertinente a tu problema, no contar celdas destacadas.
Anthropic reporta hasta 30% más velocidad de generación que 5.1. Eso no significa terminar cualquier trabajo 30% antes: herramientas, cantidad de pasos, reintentos y revisión también consumen tiempo.
Precio API: baja la tarifa, no necesariamente el costo por tarea
La ficha oficial de Fable 5.2 permite separar los componentes del presupuesto. Mythos comparte sus precios.
| Componente | Precio en USD por MTok |
|---|---|
| Entrada nueva | US$8 |
| Salida | US$40 |
| Escritura de caché de 5 minutos | US$10 |
| Escritura de caché de 1 hora | US$16 |
| Lectura de caché | US$0,20 |
| Fast: entrada / salida | US$16 / US$80 |
La caché reutiliza prefijos ya procesados: escribirlos tiene una tarifa y volver a leerlos otra. No todo el contexto se factura automáticamente como lectura barata. La ficha también anuncia un descuento Batch de 50% en entrada y salida; no es la modalidad interactiva de una conversación.
Frente a 5.1, entrada y salida bajan de US$10/US$50 a US$8/US$40: 20% menos tarifa. Si el modelo da más pasos o usa más razonamiento, el costo final puede subir. La propia guía advierte que, a esfuerzos altos, puede crear subagentes para revisar trabajo y que estos pueden concentrar una parte importante del gasto.
Fast es una modalidad opcional: Anthropic anuncia hasta 2,5 veces más velocidad de generación, al doble de tarifa base. No duplica necesariamente la velocidad de todo el proceso. Confirmá su soporte por plataforma; no está disponible en cualquier modalidad de alojamiento.
Estos son precios de API por consumo, no el valor mensual de Pro, Max o Team. El anuncio incluye una promoción temporal de uso para planes elegibles: no conviene tratar sus resets y cupos como condiciones permanentes de la suscripción.
Cuándo elegirlo frente a Opus 5.5
Anthropic recomienda Opus 5.5 como punto de partida para programación y trabajo de conocimiento. Fable queda para problemas técnicos más ambiciosos y abiertos. Opus cuesta US$4/US$20 por MTok: la mitad de la tarifa base de Fable, con la misma tarifa de lectura de caché.
Eso no decide por sí solo el costo por resultado. Un modelo más caro por token podría necesitar menos intentos; otro podría ser suficiente sin el sobrecosto. La comparación debe medir tareas aceptadas, no solamente tokens baratos.
FrontierCode 2.0 permite ver esa diferencia: evalúa si mantenedores de repositorios aceptarían los cambios de código. El eje vertical muestra puntuación; el horizontal, costo por tarea en USD, en escala logarítmica. Cada punto corresponde a un nivel de esfuerzo.
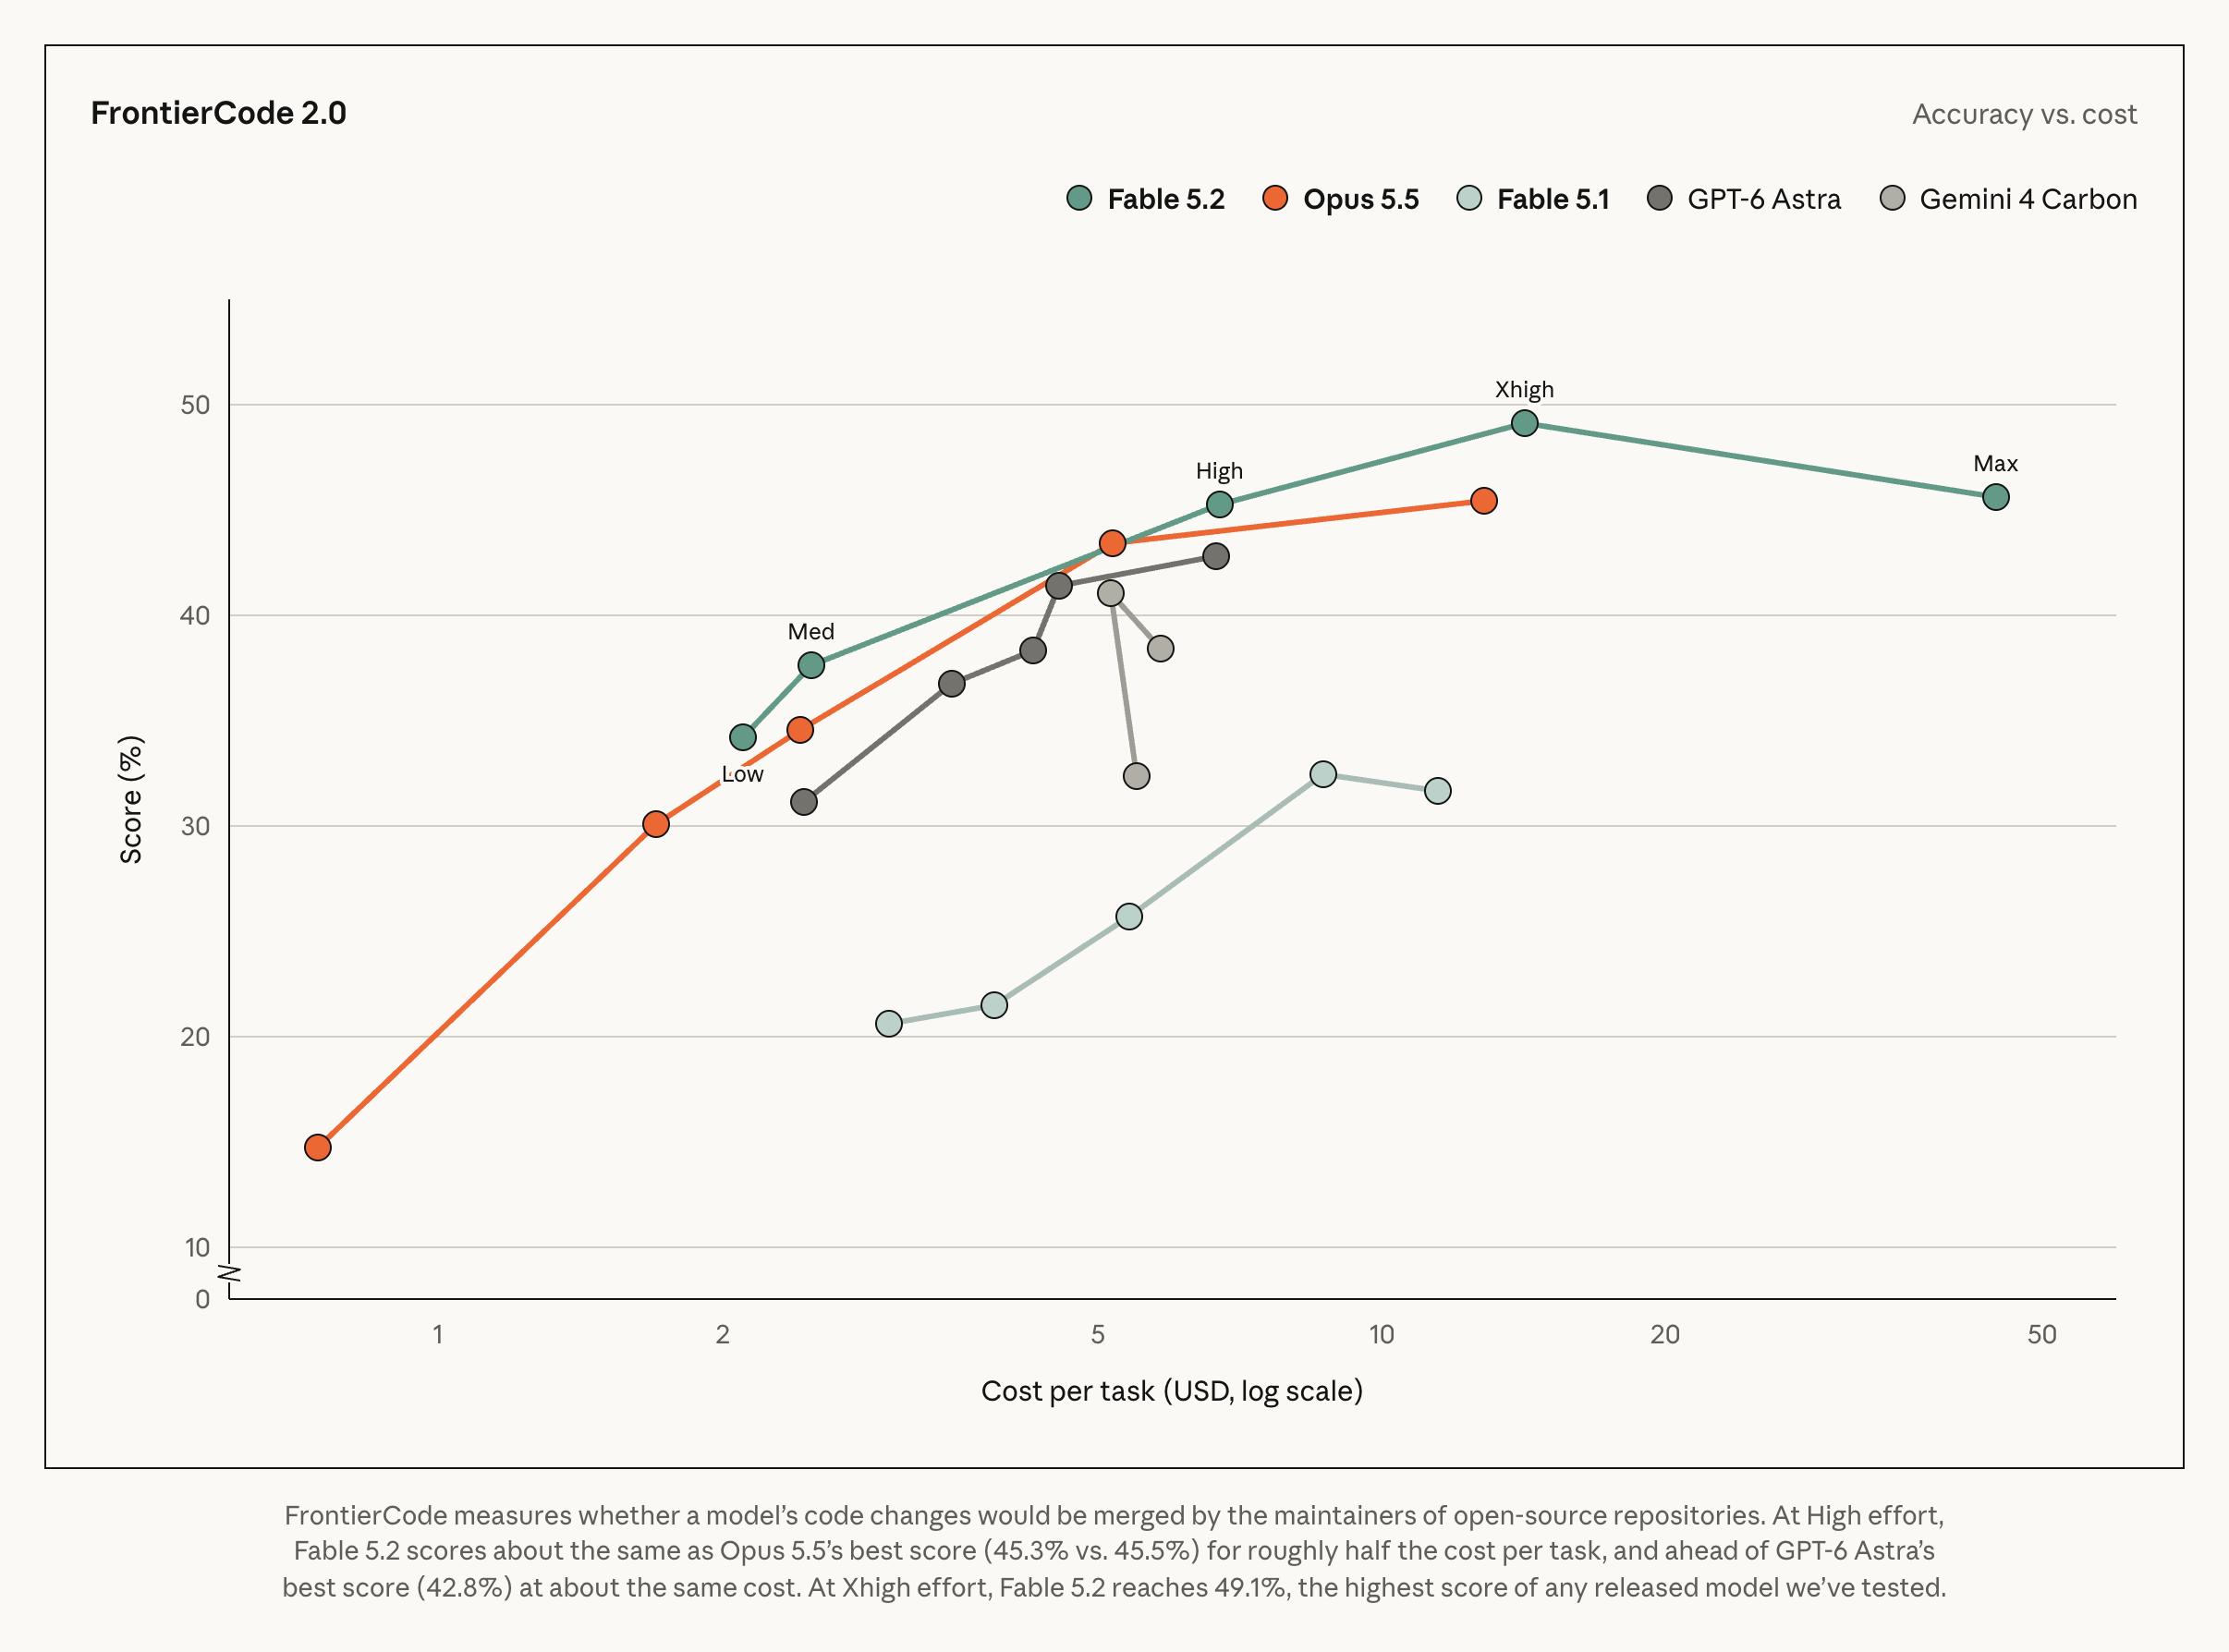
Fuente: Anthropic. Reporta Fable 5.2 High en 45,3% frente al mejor Opus 5.5 en 45,5%, a aproximadamente la mitad del costo por tarea en este benchmark; no garantiza ese ahorro en clientes. Abrí el gráfico completo (2412 × 1788) para ampliar notas y curvas.
Si ya usás Opus, primero identificá qué falla: falta de contexto, herramientas mal conectadas y criterios ambiguos no prueban falta de capacidad del modelo. Para revisar las diferencias de esa base, está el análisis de Opus 5.5 y su migración.
Migración: cuatro diferencias que pueden romper el flujo
La guía vigente de migración dice que el paso desde Fable 5.1 es mayormente directo, pero identifica cuatro incompatibilidades. No alcanza con copiar el checklist histórico de 5.1.
- El prefijo se verifica en todas las cuentas. Los bloques de razonamiento quedan ligados a las instrucciones, herramientas e historial anteriores. Editarlos puede producir un 400 de firma inválida. Incluso una lista de herramientas MCP que cambia entre peticiones cuenta como edición en 5.2. Mantené el historial append-only: agregá sin reescribir lo anterior.
- La compatibilidad de thinking tiene dirección. En Claude API y Google Cloud administrado por Google, 5.2 lee los bloques anteriores, pero Fable 5.1 y Opus 5.5 no leen los de 5.2. La API descarta los incompatibles sin facturar esos tokens de entrada; reconstruir el razonamiento puede aumentar costo y latencia. Además, los bloques quedan ligados a la cuenta o cuentas vinculadas.
- Cambia computer use.
computer_20251124devuelve 400 excepto en Amazon Bedrock. La alternativa escomputer_toolset_20260801, actualizando también el bucle que procesa las herramientas. - Cambia la pareja executor/advisor. Si usás esa herramienta beta, un executor 5.2 solo acepta Fable 5.2 o Mythos 5.2 como advisor. Cambiarlo modifica las herramientas: hacelo en conversaciones nuevas.
Se mantienen restricciones anteriores: thinking adaptativo siempre activo, sin tools forzadas mediante any o tool. En organizaciones con claves de cifrado administradas por el cliente, structured outputs no está disponible para estos modelos; corresponde validar la salida en el código.
Al venir de Opus 5.5, fijá effort explícitamente: su valor API predeterminado es medium, frente a high en Fable. En las aplicaciones de Claude y Claude Code, el anuncio indica medium. La nota histórica sobre Fable 5.1 conserva el contexto de aquella versión, no estas condiciones nuevas.
Retención: 30 días salvo autorización, EFS en beta privada
Fable 5.2 y Mythos 5.2 requieren por defecto 30 días de retención para monitoreo de seguridad. No están disponibles bajo Zero Data Retention salvo autorización expresa de Anthropic. En Claude API, un workspace sin la retención requerida puede recibir un 400.
Enterprise Frontier Safeguards (EFS) está ahora en beta privada. El anuncio explica que permite monitoreo automatizado sobre prompts y respuestas almacenados en infraestructura del cliente, compatible con ZDR. Los clientes elegibles pueden seguir usando estos modelos con ZDR antes de implementar EFS.
No es ZDR abierto para todos ni EFS generalmente disponible. Antes de enviar datos sensibles, confirmá por escrito elegibilidad, workspace, plataforma y condiciones efectivas. Una solicitud comercial pendiente no es una configuración de privacidad.
Una evaluación acotada antes de cambiar producción
Elegí tareas reales difíciles con resultados verificables y conservá casos fáciles como control. Ejecutá Opus 5.5 y Fable 5.2 con el mismo contexto, herramientas y criterio de aceptación; después explorá distintos niveles de esfuerzo.
Registrá calidad aceptada, costo completo, latencia, bloqueos, reintentos e intervención humana. Probá una conversación larga, un fallback y cualquier cambio de herramientas. Definí cuándo revertir antes del corte, no después del primer incidente.
Si el trabajo puede modificar sistemas, separá preparar de ejecutar y revisá los límites y permisos antes de darle una tarea a una IA. Si necesitás ordenar esa evaluación con tu equipo, podemos trabajar sobre el proceso y sus criterios de aceptación.
Preguntas frecuentes
¿Fable 5.2 puede generar imágenes o video?
No según su ficha técnica: recibe texto e imágenes y devuelve texto. Las demostraciones de hardware y robótica no cambian esa modalidad de entrada y salida.
¿Tener Claude Enterprise da acceso directo a Mythos 5.2?
No equivale a acceso directo al modelo. Enterprise permite usar Claude Security con Mythos 5.2, según Anthropic; el acceso directo a Mythos requiere verificación.
¿Un límite bajo de max_tokens evita pagar razonamiento?
No. El razonamiento cuenta dentro de max_tokens y puede consumirlo antes de producir texto. La guía recomienda revisar ese límite o bajar effort.
¿Reintentar una petición corrige un error de firma de thinking?
No si reenviás el mismo cuerpo. Corregí la edición del prefijo o descartá los bloques afectados mediante los controles documentados, como solución transitoria.
Del artículo a tu negocio
¿Querés aplicar IA a un proceso de tu negocio?
Contame cómo lo resolvés hoy y qué querés mejorar. Reviso tu caso y te digo si puedo ayudarte y qué servicio encaja.
Escribir no reserva una llamada ni contrata un servicio.

Especialista en Agentes de IA · Copenhague
Diseño e implemento agentes IA, MCP servers y harnesses en producción: el loop, las herramientas y el contexto que hacen que un modelo pase de contestar a trabajar. Todo lo que ves en este sitio está construido así.