Gemini 4 Hydrogen: precio, benchmarks y cuándo probarlo
En este artículo
Google presentó Gemini 4 Hydrogen el 12 de noviembre de 2026: un modelo para tareas de programación, análisis y trabajo multimodal que busca combinar capacidad y velocidad. Su tarifa anunciada de API es de US$1,50 por millón de tokens de entrada y US$7,50 por millón de salida.
Un token es una unidad de procesamiento, no necesariamente una palabra.
La decisión no se resuelve con la tarifa ni con un primer puesto en una tabla. Si tu equipo procesa documentos, desarrolla software o necesita respuestas con un tiempo de espera acotado, Hydrogen merece una prueba contra el modelo que ya usa. Cambiar todo por el anuncio sería adelantarse a esa evidencia.
Este análisis es documental: se apoya en el anuncio de Google, su metodología y documentación consultados el 12/11/2026. No probé Hydrogen ni hice un benchmark propio. Precios, acceso y condiciones pueden cambiar.
Qué es Hydrogen y dónde se usa
Hydrogen es un modelo de IA, no un módulo que se instala por separado. El modelo procesa una entrada y genera una respuesta; un producto o una aplicación decide cómo presentarlo, qué herramientas conectarle y qué permisos darle.
Google lo presenta para programación iterativa, seguimiento de instrucciones y trabajo con materiales como documentos, gráficos, audio y video. Por ejemplo, podría ayudar a revisar un informe con tablas y preparar una síntesis con referencias.
Que acepte ese material no demuestra que cada cifra o cita de la síntesis sea correcta: hay que contrastarlas con el original.
Para desarrolladores, Google anuncia acceso mediante Gemini API y AI Studio, además de Android Studio en su modalidad paga. También menciona Antigravity para suscriptores pagos de Google AI Pro o Ultra.
Para empresas anuncia opciones en Gemini for business y otras superficies elegibles; para usuarios finales, despliegue en la aplicación Gemini y Search.
La disponibilidad del modelo no implica las mismas condiciones en cada producto. Una suscripción a una aplicación no equivale a una tarifa de API ni confirma que tu cuenta, región o integración tengan acceso. Consultá la pantalla y las condiciones de la superficie que pensás usar antes de presupuestar o integrar.
Precio API: cuánto cuesta y qué falta para calcular una tarea
El anuncio oficial publica una tarifa plana a lo largo de la ventana de contexto de un millón de tokens:
| Consumo API | Precio anunciado por millón de tokens |
|---|---|
| Entrada | US$1,50 |
| Salida | US$7,50 |
Es una tarifa por consumo de modelo, no el precio mensual de Google AI Pro o Ultra. Tampoco incluye aquí un supuesto descuento por caché, modalidad por lotes, herramientas externas o infraestructura: revisá las condiciones aplicables a tu plataforma.
Para ponerle escala, una carga hipotética de 800.000 tokens de entrada y 100.000 de salida facturada costaría US$1,95 a esas tarifas: US$1,20 de entrada más US$0,75 de salida. Es solo una cuenta aritmética; no predice el consumo de una tarea ni incluye otros cargos.
Los 100.000 tokens de salida del ejemplo incluyen el razonamiento facturado, no solo la respuesta visible. Superan el límite de un segmento en primer plano, por lo que requieren el mecanismo de continuación documentado.
La tarifa es como el precio por kilómetro; el costo del viaje depende de cuántos kilómetros recorras. Más pasos, razonamiento, llamadas, reintentos o revisión humana pueden cambiar el costo por resultado aceptado.
El análisis de 3.8 Flash profundiza esa diferencia, aunque sus cifras históricas no deben trasladarse a Hydrogen.
El millón de tokens es una ventana compartida
El anuncio habla de hasta un millón de tokens de entrada y hasta un millón de salida. La documentación de Google Cloud precisa una condición decisiva: entrada y salida comparten un límite de 1.048.576 tokens. La salida incluye razonamiento, llamadas a funciones y respuesta final.
No son un millón para documentos más otro millón independiente para responder. Si llenás gran parte de la ventana con material de entrada, queda menos espacio para el resto.
Un segmento en primer plano genera hasta 65.536 tokens de salida; las salidas más largas requieren el mecanismo de continuación documentado y siguen sujetas al presupuesto compartido.
Pensalo como una mesa de trabajo: los documentos ocupan espacio antes de que empieces a redactar. Una mesa grande permite desplegar más material, pero no garantiza encontrar bien cada dato.
Seleccionar fuentes, pedir referencias y verificar una muestra siguen siendo parte del trabajo.
Cuatro niveles de razonamiento y una afirmación de velocidad
Google documenta low, medium, high y xhigh; high es el valor predeterminado. Son maneras de ajustar el esfuerzo de razonamiento. El nivel más alto puede valer la pena en una tarea difícil, pero no hay motivo para asumir que compensa su costo y espera en todas las solicitudes.
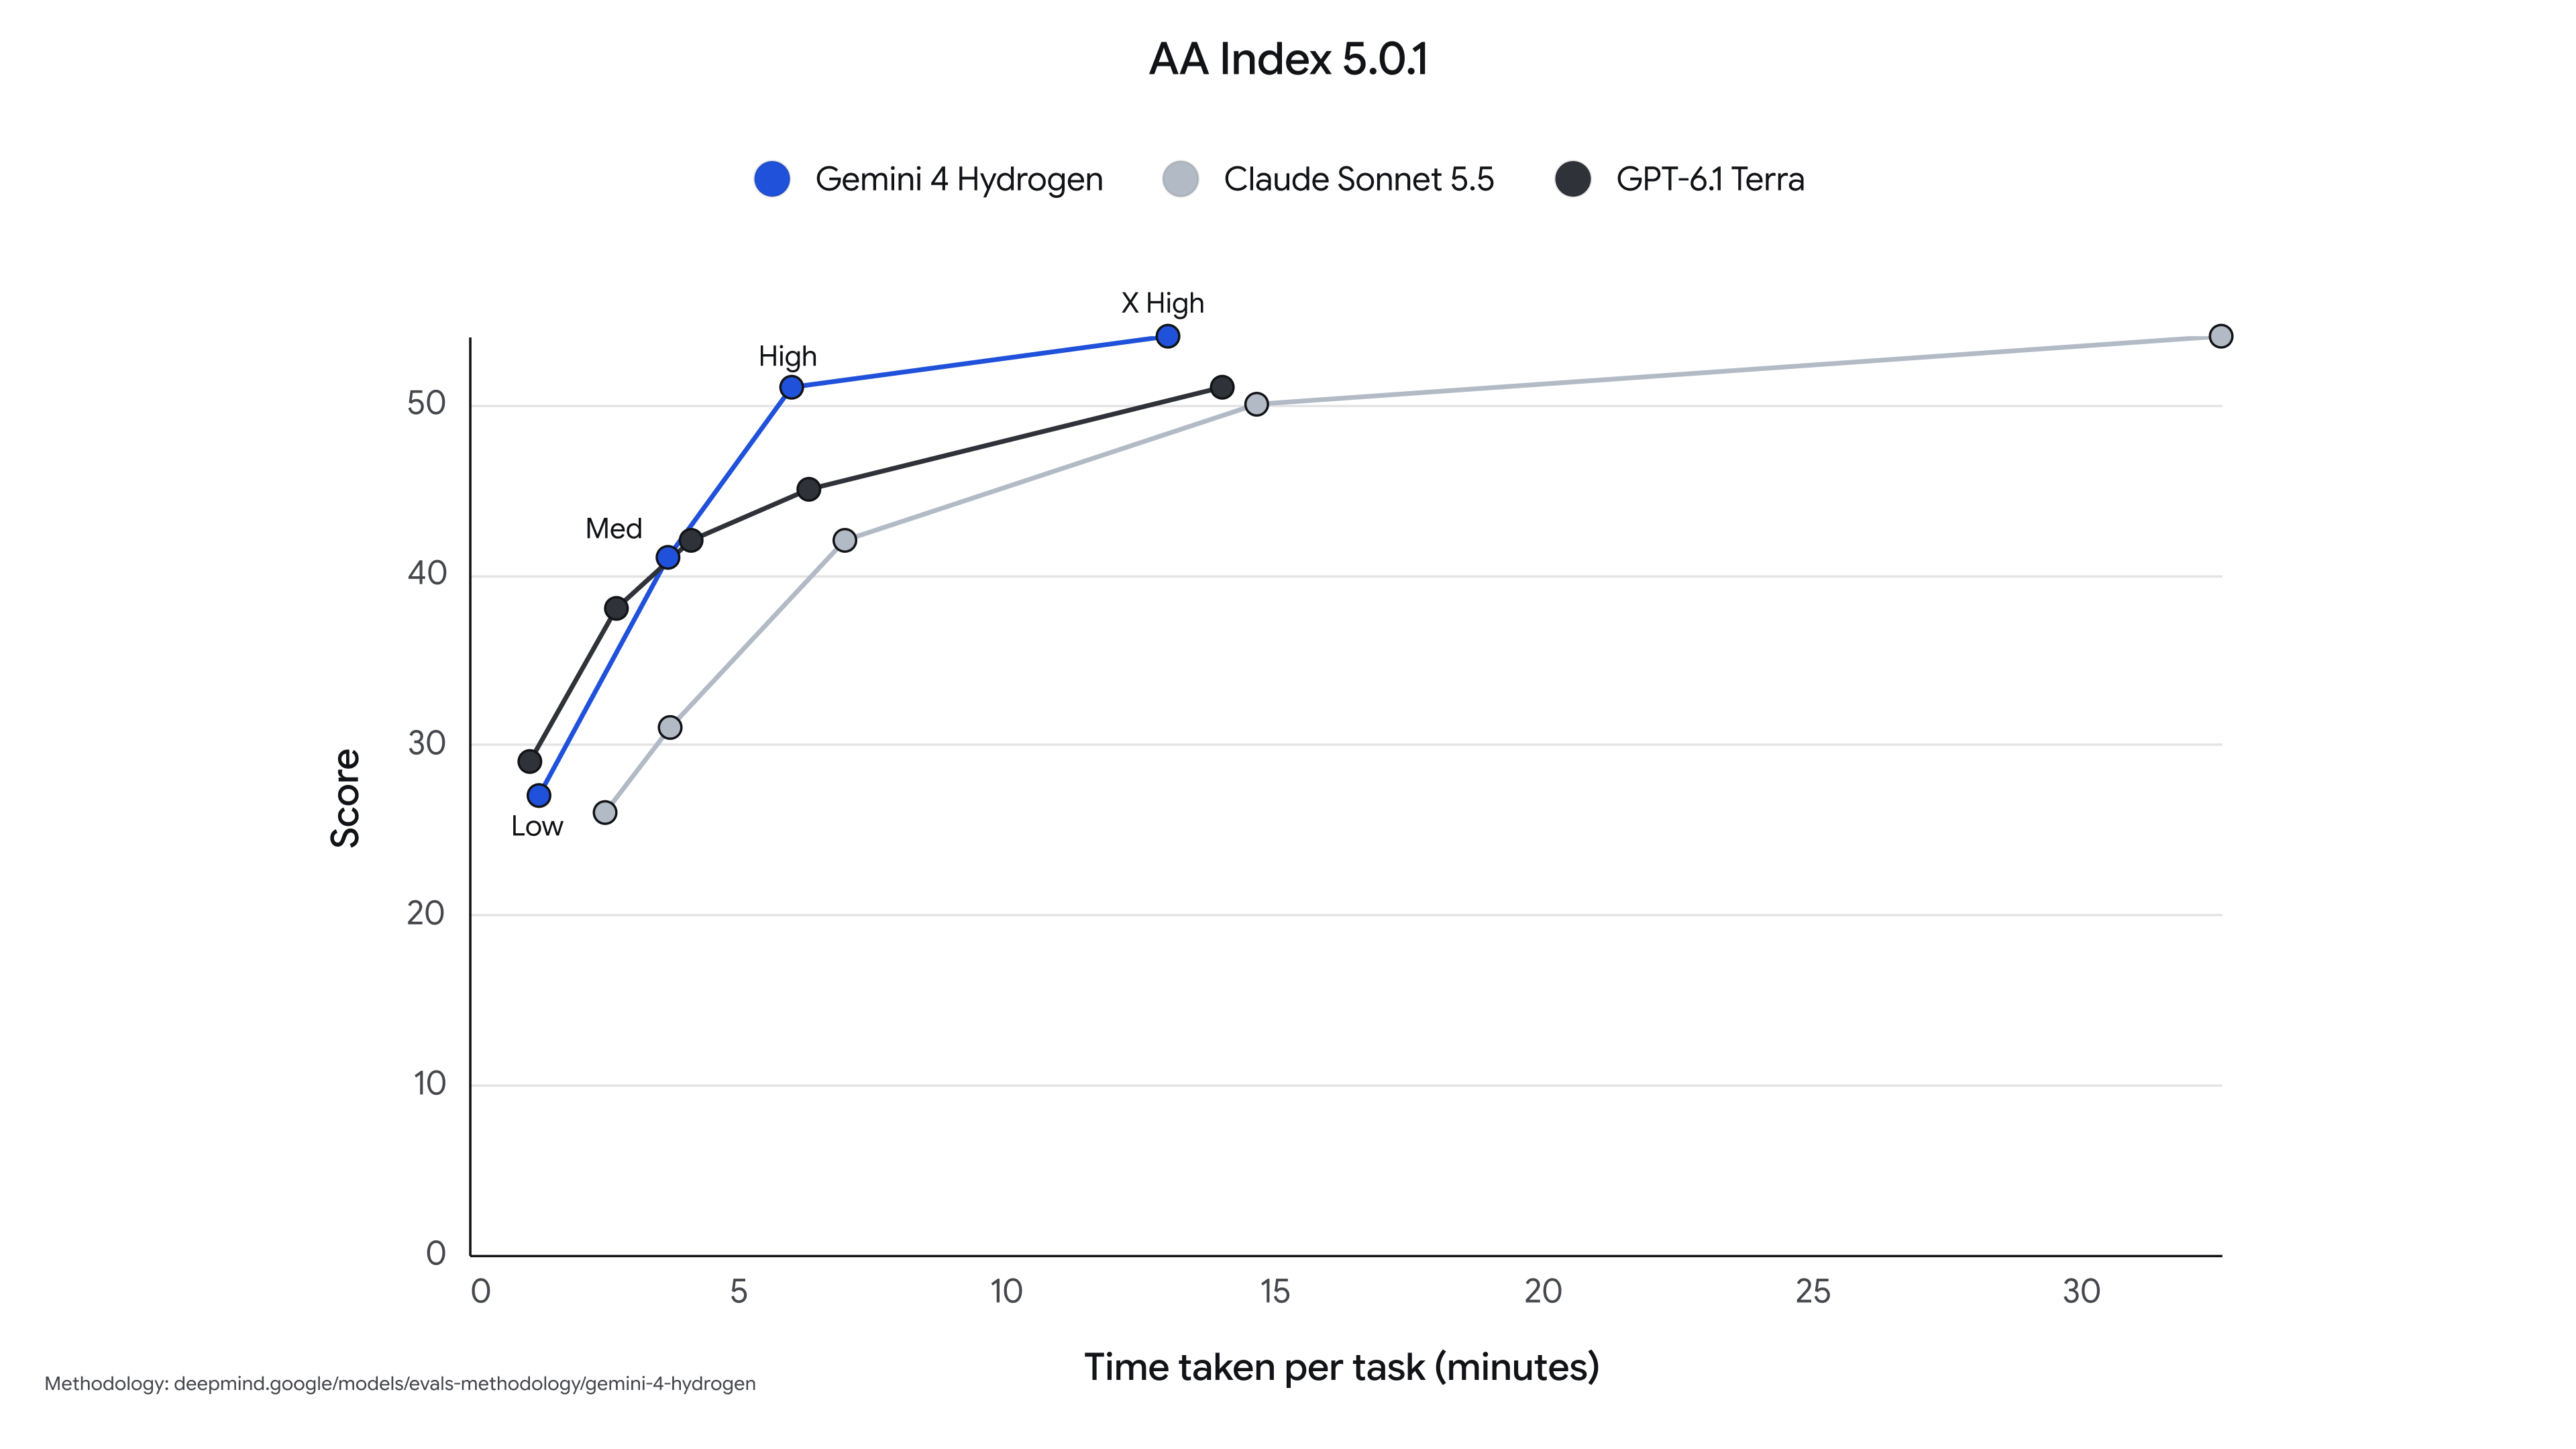
En su anuncio, Google afirma que Hydrogen completa tareas 2,5 veces más rápido que Gemini 3.8 Flash con high predeterminado. Es una comparación del proveedor, no una medición de este sitio ni una garantía para cualquier integración.
Fuente: Google. Original completo; abrilo para ampliar.
Según Google, el eje horizontal muestra minutos por tarea y el vertical, puntuación en AA Index 5.0.1: más arriba es mayor puntuación y más a la izquierda, menos tiempo. Los puntos de Hydrogen muestran sus niveles de razonamiento; son resultados reportados por Google, no una validación independiente.
Esto no equivale a que todo un proceso termine 2,5 veces antes: también cuentan herramientas, reintentos y revisión. Medí tiempo hasta resultado aceptado.
Si venís de otro modelo, revisá la configuración antes de cambiar el identificador: la documentación de Cloud indica que thinking_budget o MINIMAL producen un error de validación y que parámetros personalizados de muestreo se ignoran.
Esa observación corresponde a la superficie documentada; comprobá la guía vigente de tu integración.
Benchmarks: qué muestra la comparación oficial
Google publica la siguiente tabla para comparar Hydrogen con Claude Sonnet 5.5 y GPT-6.1 Terra. La imagen se conserva completa y la transcripción reproduce sus filas, columnas y condiciones visibles.
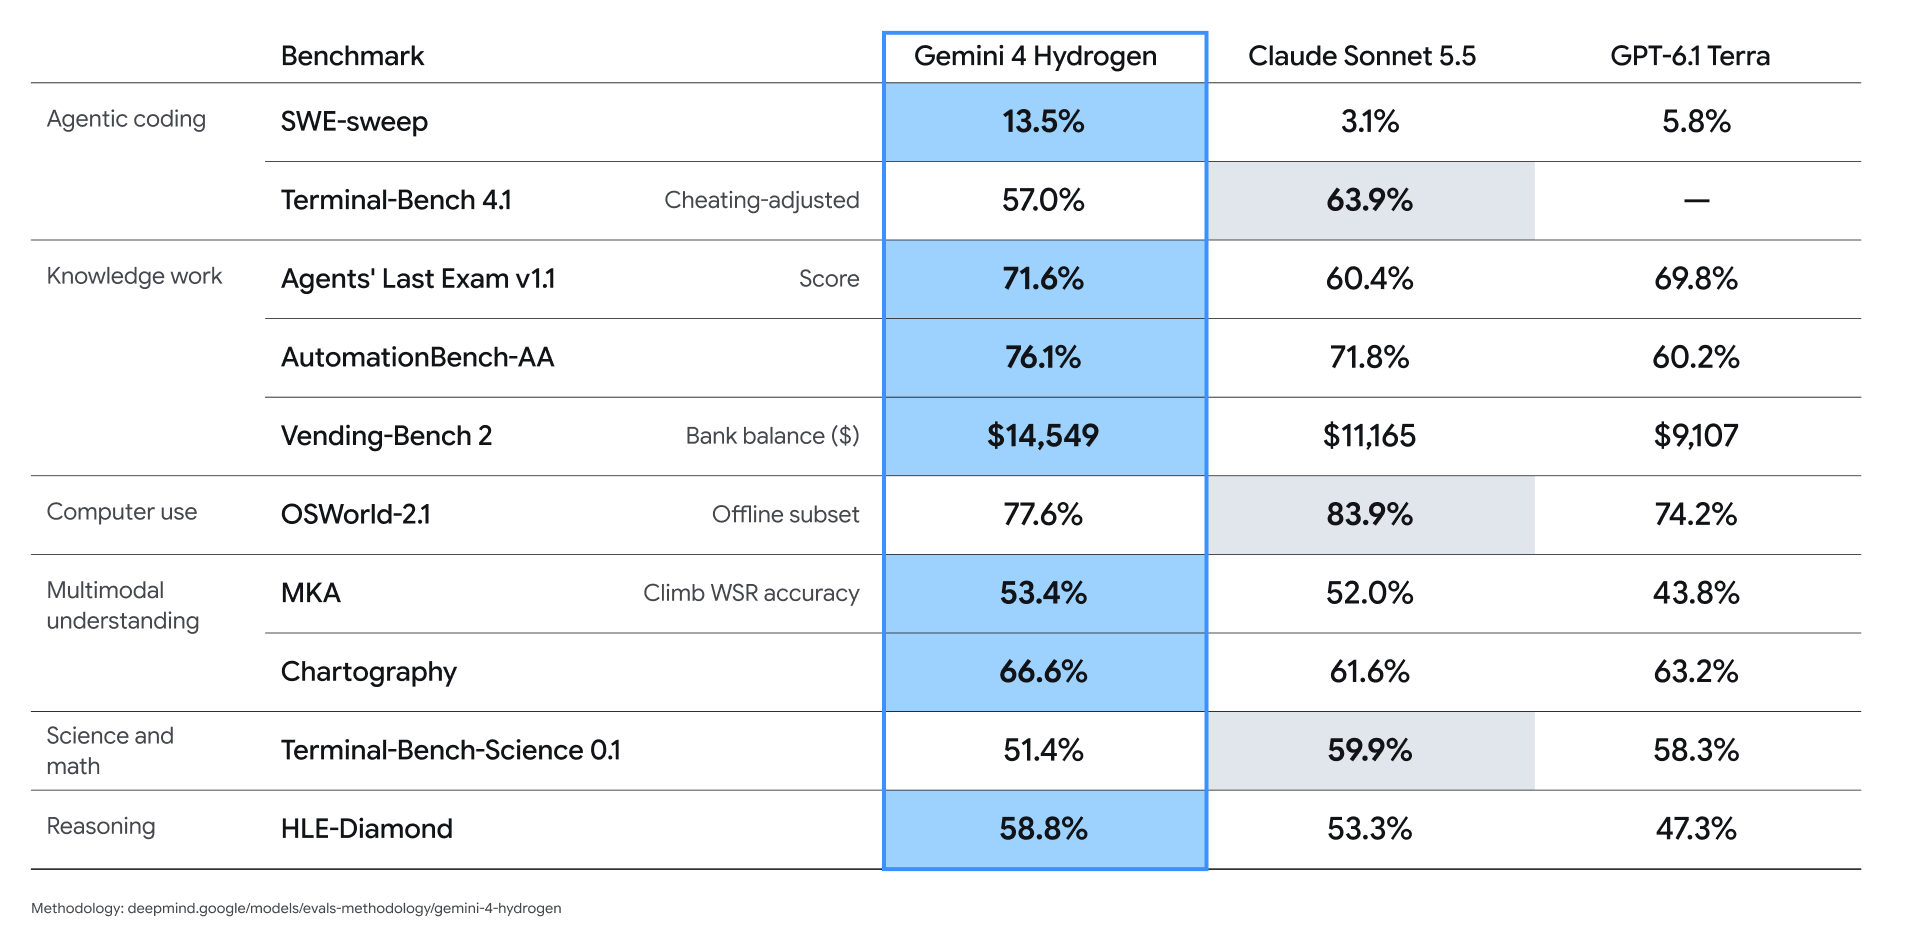
Fuente: anuncio de Google. Original completo; abrilo para ampliar. Es evidencia publicada por el proveedor, no una validación independiente.
| Área y evaluación; condición indicada | Hydrogen | Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| Programación agéntica: SWE-sweep | 13,5% | 3,1% | 5,8% |
| Programación agéntica: Terminal-Bench 4.1; ajustado por trampas | 57,0% | 63,9% | — |
| Trabajo de conocimiento: Agents’ Last Exam v1.1; puntuación | 71,6% | 60,4% | 69,8% |
| Trabajo de conocimiento: AutomationBench-AA | 76,1% | 71,8% | 60,2% |
| Trabajo de conocimiento: Vending-Bench 2; saldo en dólares | US$14.549 | US$11.165 | US$9.107 |
| Uso de computadora: OSWorld-2.1; Offline subset | 77,6% | 83,9% | 74,2% |
| Comprensión multimodal: MKA; exactitud Climb WSR | 53,4% | 52,0% | 43,8% |
| Comprensión multimodal: Chartography | 66,6% | 61,6% | 63,2% |
| Ciencia y matemática: Terminal-Bench-Science 0.1 | 51,4% | 59,9% | 58,3% |
| Razonamiento: HLE-Diamond | 58,8% | 53,3% | 47,3% |
El guion significa que la imagen no informa un valor, no que el modelo haya obtenido cero. El saldo de Vending-Bench es la métrica de esa prueba, no una ganancia empresarial demostrada.
La tabla muestra tanto fortalezas como límites: Hydrogen obtiene 13,5% en SWE-sweep, pero Sonnet figura por encima en Terminal-Bench 4.1 y en el «Offline subset» de OSWorld. La metodología identifica ese subconjunto como una selección de tareas sin internet.
Eso alcanza para descartar la lectura de que Hydrogen gana todas las pruebas; no alcanza para elegir un ganador universal.
La metodología de Google explica por qué. Salvo indicación, las evaluaciones usan el mayor nivel de razonamiento; Terminal-Bench 4.1 para Hydrogen usa high y promedia cinco intentos por tarea.
Algunas cifras provienen de ejecuciones de Google, otras de proveedores o rankings externos. Los entornos y herramientas no son necesariamente idénticos.
En una evaluación de programación, por ejemplo, el resultado depende también de qué archivos se le muestran al modelo, qué comandos puede ejecutar y cómo se decide si el cambio funciona.
El harness es esa capa de instrucciones, herramientas y reglas alrededor del modelo. El porcentaje describe la prueba publicada, no garantiza que tu sistema obtenga el mismo resultado.
Cuándo probarlo y cuándo no migrar
Lo probaría si tenés una tarea repetida donde importe el equilibrio entre calidad, espera y costo: extraer información de documentos, analizar un informe con gráficos o corregir un error reproducible de código. Elegí una tarea cuyo resultado pueda comprobar una persona o una prueba automática.
No cambiaría todo el sistema si el modelo actual ya cumple el objetivo, si todavía no conocés las condiciones de acceso o si el único argumento es una celda de la tabla.
Tampoco asumiría que Hydrogen reemplaza automáticamente a Argon o Carbon: son modelos distintos y cada carga necesita su propia comparación. Para contexto, podés leer los análisis de Argon y Carbon.
Un piloto acotado puede seguir este recorrido:
- Definí el resultado: qué respuesta o cambio se acepta y qué error lo descalifica. En una extracción, por ejemplo, verificá campos y referencias contra los documentos.
- Conservá condiciones comparables: misma tarea, contexto, herramientas y criterio de evaluación para Hydrogen y el modelo actual. Registrá cualquier diferencia inevitable.
- Medí el recorrido completo: calidad aceptada, consumo facturado, tiempo, reintentos y minutos de revisión. Probá niveles de razonamiento distintos sin mezclar sus resultados.
- Limitá el impacto: usá datos apropiados para la prueba y permisos mínimos. Si el modelo propone modificar un sistema, separá la propuesta de la ejecución y pedí revisión humana.
Una salida convincente puede contener un dato inventado; una prueba exitosa tampoco prueba que las siguientes lo serán.
Si el proceso trabaja con información sensible, confirmá antes las condiciones de tratamiento y retención aplicables a tu cuenta y plataforma.
Mi conclusión: Hydrogen suma una opción para evaluar trabajo cotidiano y multimodal, no una razón para dejar de medir. La comparación que importa es si resuelve mejor tu tarea, con límites y costos que tu equipo pueda sostener.
Si necesitás ordenar esa evaluación con tu equipo, podemos trabajar sobre el proceso y sus criterios de aceptación.
Fuentes y alcance
Consulta: 12/11/2026. Las cifras de rendimiento se atribuyen a Google o a las fuentes identificadas en su metodología; no hay prueba propia ni verificación independiente de los resultados. Portada: imagen oficial de Google, recortada para este artículo.
Del artículo a tu negocio
¿Querés aplicar IA a un proceso de tu negocio?
Contame cómo lo resolvés hoy y qué querés mejorar. Reviso tu caso y te digo si puedo ayudarte y qué servicio encaja.
Escribir no reserva una llamada ni contrata un servicio.

Especialista en Agentes de IA · Copenhague
Diseño e implemento agentes IA, MCP servers y harnesses en producción: el loop, las herramientas y el contexto que hacen que un modelo pase de contestar a trabajar. Todo lo que ves en este sitio está construido así.