Claude Sonnet 5.5: qué cambia, precio y el costo real por tarea
En este artículo
Claude Sonnet 5.5 es el sucesor directo de Sonnet 5, presentado el 28 de septiembre de 2026 según la página oficial del modelo, con la misma tarifa — US$2 y US$10 por millón de tokens de entrada y salida, y lecturas de caché a US$0,20 — y dos promesas de Anthropic: generación de salida más de 30% más rápida y hasta 30% menos costo por tarea en la mayoría del trabajo. Los benchmarks propios de Anthropic muestran saltos grandes en tareas agénticas. Pero la evaluación independiente de Artificial Analysis estima un costo por tarea ~50% más alto que el de Sonnet 5, por mayor consumo de tokens. Ninguna de las dos partes miente necesariamente: miden cargas distintas. El número que decide tu migración es el de tu propio workload.
Portada: composición editorial de Nicolas Farchica sobre la fotografía oficial del horizonte terrestre y la cápsula publicada por Anthropic en la página oficial del modelo — recorte 1200×630 del hero original más la etiqueta «Claude Sonnet 5.5» en la tipografía de esta publicación; no es la portada oficial sin alterar de Anthropic.
Si venís del análisis del lanzamiento de Sonnet 5, el contexto es directo: allá la pregunta era si la capa media alcanzaba a la frontera; acá la pregunta es si la nueva versión abarata o encarece la misma tarea. Y esa pregunta tiene hoy dos respuestas publicadas que no coinciden.
Los datos volátiles de esta nota están fechados al lanzamiento. Es un análisis documental basado en fuentes oficiales de Anthropic y en la evaluación independiente de Artificial Analysis: no corrí benchmarks propios, cada tabla cita su fuente, y los resultados de harnesses distintos nunca se mezclan.
Qué es Claude Sonnet 5.5 (y qué no es)
Sonnet 5.5 es un modelo, no un producto. Es la nueva iteración del modelo estándar de la casa, disponible en la Claude API y en las superficies de Claude, con esta ficha según la documentación oficial:
| Dato | Valor |
|---|---|
| Presentación | 28 de septiembre de 2026 (página oficial del modelo) |
| Ventana de contexto | 1.000.000 tokens |
| Máximo de salida | 128.000 tokens |
| Entrada / salida | US$2 / US$10 por millón de tokens |
| Lecturas de caché | US$0,20 por millón de tokens |
| Thinking | Adaptativo, activo por defecto |
| Esfuerzo por defecto (API) | high |
Lo que no es: no es un modelo de frontera reemplazando al segmento medio, ni un relanzamiento de precios. La jugada es otra — misma tarifa, modelo nuevo — y eso concentra toda la atención en dos números: cuánto rinde y cuántos tokens consume por tarea.
Las promesas de Anthropic: rápido, y ¿más barato por tarea?
La página oficial hace dos promesas medibles contra Sonnet 5. Primera: la generación de salida es más de 30% más rápida. Segunda: el costo por tarea baja hasta 30% en la mayoría del trabajo.
Leé los calificativos, porque sostienen todo el claim: "hasta", "la mayoría", y la propia aclaración de la página de que el costo por tarea varía con el esfuerzo y con el benchmark. No es un descuento de tarifa — la tarifa está congelada —. Es la apuesta a que el modelo resuelve la misma tarea en menos tokens.
Ahí vive la tensión de este lanzamiento: con el precio por token idéntico, el costo por tarea queda decidido por cuántos tokens consume la tarea. Si Sonnet 5.5 llega más directo, baja. Si razona más pasos antes de responder, sube. El proveedor dice una cosa; el independiente midió la otra. Vamos con cada fuente por separado.
Benchmarks según Anthropic: los números del proveedor
Advertencia metodológica única para esta tabla: estos números los reporta Anthropic, en evaluaciones que corrió Anthropic con su propio harness. No hay verificación independiente de estas cifras específicas; la independiente viene después, en su propio bloque.
| Benchmark | Sonnet 5.5 | Sonnet 5 |
|---|---|---|
| Terminal-Bench 4.0 (trabajo agéntico en terminal) | 70,6% | 10,3% |
| CursorBench 4.0 (código en IDE) | 55,5% | 34,1% |
| FrontierCode 1.1, split Main (esfuerzo máximo) | 46,2% | 42,4% |
| HLE con herramientas | 64,5% | 54,9% |
| OSWorld 2.1 (computer use, parcial) | 80,1% | 57,0% |
| GDPval-AA v2.1 (knowledge work) | 1.844 | 1.449 |
| AA-Briefcase v1.1 (trabajo profesional) | 1.811 | 1.359 |
La página oficial acompaña esta tabla con gráficos de puntuación frente a costo (escala logarítmica en el eje de costo, con las categorías de esfuerzo Low a Max). Las dos vistas más relevantes para esta nota, exportadas fielmente del conmutador de gráficos oficial:
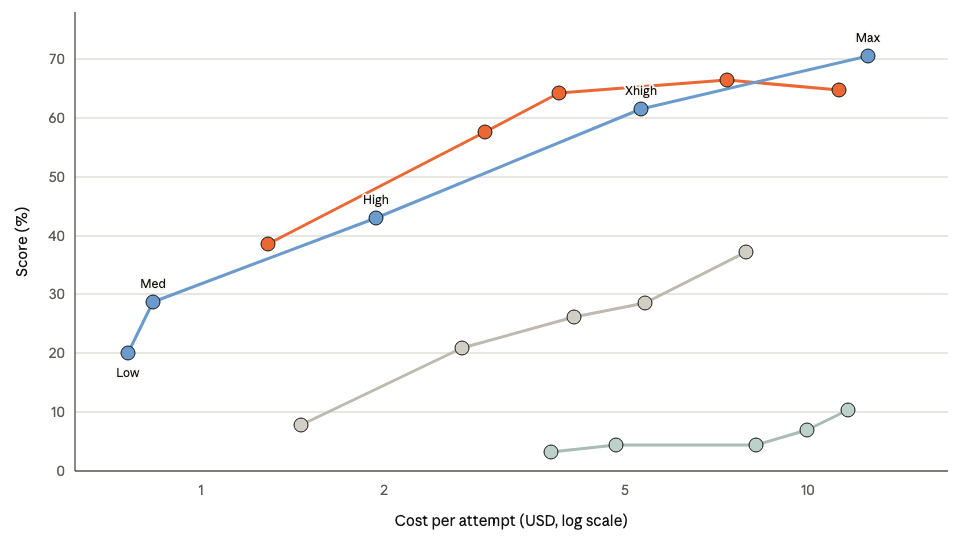
Fuente: Anthropic — Claude Sonnet 5.5, vista Terminal-Bench 4.0. Evaluaciones corridas y reportadas por Anthropic con su propio harness; export fiel del SVG oficial, capturado el 29 de septiembre de 2026. La preservación del gráfico reproduce evidencia publicada por el proveedor; no la valida de forma independiente.
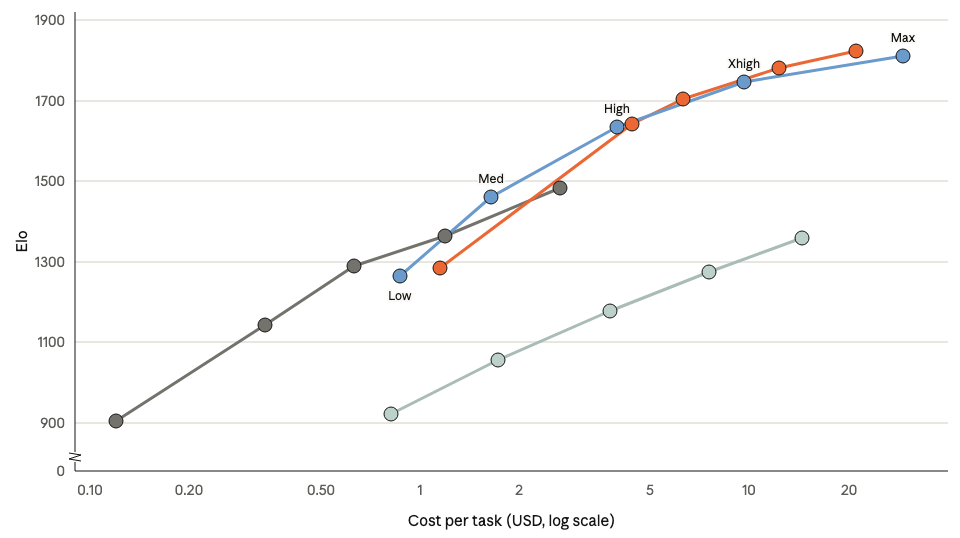
Fuente: Anthropic — Claude Sonnet 5.5, vista AA-Briefcase v1.1. «AA-Briefcase» es una evaluación de la tabla de Anthropic, no una medición de Artificial Analysis ni su estimación independiente de costo por tarea (~US$7,60, que verás más abajo en su propio bloque). Evaluaciones corridas y reportadas por Anthropic con su propio harness; export fiel del SVG oficial, capturado el 29 de septiembre de 2026.
Tres lecturas honestas de esta tabla:
- El salto concentrado está en el trabajo agéntico. Terminal-Bench 4.0 multiplica por siete el resultado de Sonnet 5. No es un ajuste fino: es otro modelo para tareas largas en terminal, que es exactamente el terreno de los harnesses de código.
- Donde el salto se acota, el calificativo importa. En FrontierCode 1.1 (Main), 46,2% contra 42,4% a esfuerzo máximo: casi cuatro puntos, el margen más chico de la tabla.
- Los calificativos son parte del dato. HLE es "con herramientas"; OSWorld 2.1 es parcial en ambos modelos; GDPval y Briefcase son puntajes de esas evaluaciones, no porcentajes. Quitarle el contexto a una celda es empezar a mentir con datos verdaderos.
La evaluación independiente: lo que mide Artificial Analysis
Artificial Analysis publicó su propia evaluación, con su harness y su mezcla de tareas. Números separados de la tabla anterior — no comparables celda a celda:
| Métrica de Artificial Analysis | Valor reportado |
|---|---|
| Intelligence Index | 56 |
| Costo estimado por tarea | US$7,60 (~50% por encima de Sonnet 5) |
| Tokens de salida por tarea del índice, a esfuerzo máximo | ~193.000 |
| Terminal-Bench 4.0 (setup de AA) | 64% (Sonnet 5: 10,3%) |
Dos cosas que esta tabla agrega y una que le falta. Agrega la señal independiente más contundente del lanzamiento: en Terminal-Bench 4.0, bajo el setup de AA, el salto también es enorme — 64% contra 10,3% —. Proveedor e independiente, midiendo por separado, coinciden en que el trabajo en terminal es donde más cambió el modelo.
Y agrega el contrapeso económico: ~193.000 tokens de salida por tarea del índice a esfuerzo máximo, con un costo estimado ~50% por encima de Sonnet 5. Con la misma tarifa, más tokens por tarea significan más costo por tarea: es aritmética, no opinión.
Lo que le falta — y AA lo dice explícitamente — es que su evaluación corrió sobre un deployment pre-release con un bug de structured output. AA afirma que el bug está corregido en el release público y espera cambios mínimos en sus cifras, o una leve subestimación a favor del modelo final. Tomá el US$7,60 como estimación fechada, no como veredicto.
Dos costos por tarea distintos: por qué nadie miente (todavía)
Puestas una al lado de la otra, las cifras parecen contradictorias: Anthropic dice hasta 30% menos costo por tarea; AA mide ~50% más. Pero no se están refiriendo a la misma tarea, ni al mismo esfuerzo, ni al mismo harness.
Anthropic mide sus workloads de referencia y condiciona el resultado al esfuerzo y al benchmark — su propio claim prohíbe leerlo como ahorro universal. AA mide la mezcla de tareas de su índice, a esfuerzo máximo, sobre un deployment pre-release. Entre esas dos condiciones hay espacio para que ambas afirmaciones sean verdaderas en su contexto.
La conclusión operativa no es "alguien cocina los números". Es que el costo por tarea no es una propiedad del modelo: es una propiedad del par modelo-workload. Ya lo vi con Gemini 3.8 Flash, donde el modelo "trabajando más" encarecía la tarea sin mover la tarifa; acá el patrón es el mismo con el signo invertido según quién mide. La tarifa por token es publicidad; el costo por tarea de tu carga real es el número que decide.
Si hoy pagás por Sonnet 5 en producción, tu migración empieza con un registro de tokens por tarea, no con la tabla de benchmarks.
Cambios de migración: lo que puede romperse
Si consumís Sonnet 5 por API, esta versión no es un reemplazo silencioso. Según la guía de migración y la página de novedades de la documentación, lo que más puede romper una integración:
- Thinking adaptativo por defecto. Ya no optás adentro; el modelo decide cuánto piensa. Si tu pipeline asumía respuestas sin thinking previo, revisalo.
between_toolsreemplaza adisabled. La forma de desactivar el thinking previo cambió de nombre y de semántica; las integraciones que seteabandisableddeben actualizarse.tool_choiceforzado no soportado. Forzar herramientas conanyotoolno está disponible en esta versión. Si tu flujo dependía de forzar una herramienta, necesitás rediseñar ese tramo antes de migrar.- Cambios en las formas de thinking blocks y de la respuesta. Impacta parsing, logging y observabilidad: todo lo que inspecciona la estructura de la respuesta puede dejar de funcionar.
- Computer use con cambios de compatibilidad en algunas plataformas. No es universal: verificá tu plataforma concreta.
- Esfuerzo recalibrado. Los niveles de effort no mapean 1:1 con los de Sonnet 5: tu tuning de
mediumohighpuede quedar en otro punto de la curva.
Nada de esto es dramático para un chat; todo es relevante para un harness que orquesta tools, mide respuestas y fija esfuerzo por tarea. La guía oficial es la fuente para el detalle fino de cada cambio.
Qué significa para tu stack
El cambio material de este lanzamiento vive en un solo subsistema del harness: la selección de modelo. El contexto, los permisos, las herramientas y la verificación que construiste siguen intactos; lo que se movió es el motor y la economía de usarlo.
Para la decisión práctica, tres movimientos:
- Congelá una evaluación propia antes de tocar producción. Un set de tareas reales, con costo y calidad medidos antes y después. Los benchmarks de Anthropic y de AA dimensionan; tu workload decide.
- Medí tokens por tarea, no precio por token. Es la métrica que separa las dos caras de este lanzamiento, y la que tu observabilidad necesita tener antes de migrar.
- Audité las dependencias de la lista anterior. Thinking forzado,
tool_choicey parsing de thinking blocks son los tres puntos de fractura más probables de una integración existente.
Si estás eligiendo dentro del catálogo de Claude en lugar de migrar versiones, la comparativa entre Fable 5, Opus 4.8 y Sonnet 5 sigue siendo el mapa por caso de uso — con la salvedad de que sus números son previos a esta versión —, y el análisis de Opus 5 cubre la capa premium. Que la capa media mejore en tareas agénticas no cambia la regla: el modelo premium sigue existiendo para los casos donde el techo de razonamiento manda.
Mi veredicto
Opinión mía, separada de los datos de arriba:
- Si tu carga es trabajo agéntico en terminal o código con herramientas, este es el salto de versión más claro del catálogo: las dos fuentes disponibles — proveedor e independiente — coinciden en la magnitud del cambio, cada una con su harness. Probalo sí o sí.
- Si tu decisión es económica, tratá el "hasta 30% más barato por tarea" como hipótesis, no como hecho: hay una estimación independiente publicada que mide lo contrario en su propia mezcla. Tu registro de tokens por tarea es el árbitro.
- Si tenés una integración con tool forcing o tuning de thinking/effort, la migración tiene trabajo real: no es cambiar un string de modelo y seguir.
- Como pieza de harness, la lección es la de siempre: el modelo es la parte reemplazable. El contexto que le das, las herramientas que le permitís y cómo verificás lo que devuelve — eso no lo versiona Anthropic.
Si querés evaluar si esta versión encaja en un proceso concreto, hablemos.
Preguntas frecuentes
¿Qué es Claude Sonnet 5.5 y cuándo salió?
Es el sucesor directo de Sonnet 5 en el catálogo de Anthropic, presentado el 28 de septiembre de 2026 según la página oficial del modelo. Tiene ventana de contexto de 1 millón de tokens, máximo de salida de 128.000, thinking adaptativo activo por defecto y una tarifa de US$2/US$10 por millón de tokens de entrada y salida, con lecturas de caché a US$0,20.
¿Cuánto cuesta Claude Sonnet 5.5?
La tarifa nominal es la misma que Anthropic presenta para Sonnet 5: US$2 por millón de tokens de entrada, US$10 por millón de salida y US$0,20 por millón de lecturas de caché. El costo por tarea es otra cosa: Anthropic afirma que baja hasta 30% en la mayoría del trabajo, y Artificial Analysis estima ~50% más en su propia mezcla de tareas. Depende del workload.
¿Claude Sonnet 5.5 es mejor que Sonnet 5?
En la tabla oficial de Anthropic lo supera en todos los benchmarks publicados, con saltos grandes en trabajo agéntico: Terminal-Bench 4.0 70,6% contra 10,3%, y CursorBench 4.0 55,5% contra 34,1%. Artificial Analysis, de forma independiente y bajo su propio setup, también mide un salto grande en Terminal-Bench 4.0: 64% contra 10,3%. Son harnesses distintos; ninguno garantiza el mismo orden en tu caso.
¿Por qué Anthropic dice que es más barato por tarea y Artificial Analysis dice que es más caro?
Porque miden tareas y esfuerzos distintos con harnesses distintos. Anthropic condiciona su claim de hasta 30% de ahorro al esfuerzo y al benchmark; AA estima US$7,60 por tarea en su índice — ~50% por encima de Sonnet 5 — tras medir un deployment pre-release que consumía ~193.000 tokens de salida por tarea a esfuerzo máximo. Con la misma tarifa, más tokens por tarea significan más costo por tarea.
¿Qué se rompe al migrar de Sonnet 5 a Sonnet 5.5?
Según la documentación oficial: el thinking adaptativo queda activo por defecto y between_tools reemplaza a disabled para desactivar el thinking previo; tool_choice forzado con any o tool no está soportado; cambian las formas de los thinking blocks y de la respuesta; hay cambios de compatibilidad de computer use en algunas plataformas; y los niveles de esfuerzo fueron recalibrados.
Fuentes
Todas consultadas en septiembre de 2026, durante el ciclo del lanzamiento:
| Fuente | Qué respalda |
|---|---|
| Anthropic — Claude Sonnet 5.5 (página oficial) | Fecha visible (28/09/2026), claims de velocidad y costo por tarea, tarifas, benchmarks del proveedor |
| Claude Docs — Sonnet 5.5 overview | Contexto 1M, salida 128K, thinking adaptativo, esfuerzo high por defecto |
| Claude Docs — What's new in Sonnet 5.5 | Thinking por defecto, between_tools, cambios de comportamiento |
| Claude Docs — Migration guide | tool_choice forzado, thinking blocks, computer use, recalibración de effort |
| Artificial Analysis — Claude Sonnet 5.5 | Intelligence Index 56, costo por tarea, tokens por tarea, Terminal-Bench bajo su setup, caveat pre-release |

Especialista en Agentes de IA · Copenhague
Diseño e implemento agentes IA, MCP servers y harnesses en producción: el loop, las herramientas y el contexto que hacen que un modelo pase de contestar a trabajar. Todo lo que ves en este sitio está construido así.
Artículos relacionados
GLM-5.3 vs GLM-5.3-Flash: cuál elegir según la tarea
Compara GLM-5.3 y GLM-5.3-Flash por modalidad, rendimiento, arquitectura y costo para elegir qué modelo probar según la tarea.
Claude Academy: cómo migrar tu progreso desde Skilljar
Claude Academy reemplaza la academia pública de Skilljar. Explico qué progreso se importa, qué certificados siguen vigentes y cómo migrar con continuidad.
Marcas de agua de Claude: qué detectan y qué no prueban
Anthropic marcará texto y archivos de Claude con señales legibles por máquina. Qué prueban, cuándo se aplican y qué sigue sin documentarse oficialmente.