Claude Haiku 5.5: análisis, precio y cuándo conviene
En este artículo
Anthropic presentó Claude Haiku 5.5, su modelo chico más rápido, barato y capaz, según su anuncio oficial. El lanzamiento se reportó el 7 de octubre de 2026, fecha corroborada con el análisis de ese mismo día de Simon Willison: el anuncio que inspeccionamos no declara fecha explícita.
Mi lectura corta: para tareas acotadas de alto volumen — resumir, clasificar, soportar, subagentes acotados — Haiku 5.5 baja mucho el costo por tarea, pero lo que pagás de verdad depende de cuatro detalles: la franja de precio de tu prompt, cuántos tokens genera tu texto, el effort que uses y los reintentos por error. Para código agéntico complejo, la propia Anthropic sigue recomendando Sonnet y Opus.
Aclaración de método: me apoyo en el anuncio oficial, la documentación y experimentos de Willison. No es un benchmark propio: los números de rendimiento son claims del fabricante, atribuidos como tales.
La ficha, en una tabla
| Dato | Claude Haiku 5.5 |
|---|---|
| Lanzamiento | 7 de octubre de 2026 (corroborado por fuente secundaria fechada) |
| Contexto / salida | 1 millón de tokens de contexto · hasta 128k de salida |
| Effort | Ajustable (primer Haiku que lo permite); medium por defecto, adaptive thinking activado |
| Model ID | claude-haiku-5-5 |
| Disponibilidad | Todas las plataformas de Anthropic, incluidas AWS, Google Cloud y Microsoft Azure |
Qué dice Anthropic y qué no pudimos verificar
Anthropic lo posiciona para resúmenes, compactación de contexto, consultas a bases de datos, clasificación, soporte en vivo y navegación, y subagentes de código acotados, y estima que operarlo cuesta en promedio ~75% menos que Haiku 4.5 — estimación del fabricante que depende de la mezcla real de uso, no una medición universal.
El anuncio incluye además una tabla comparativa de rendimiento con cuatro modelos: Haiku 5.5, Haiku 4.5, GPT-6 Luna y Sonnet 5.5, con esta última columna marcada for reference (como referencia) por el propio Anthropic.
La tabla comparativa oficial: cuatro modelos y sus condiciones
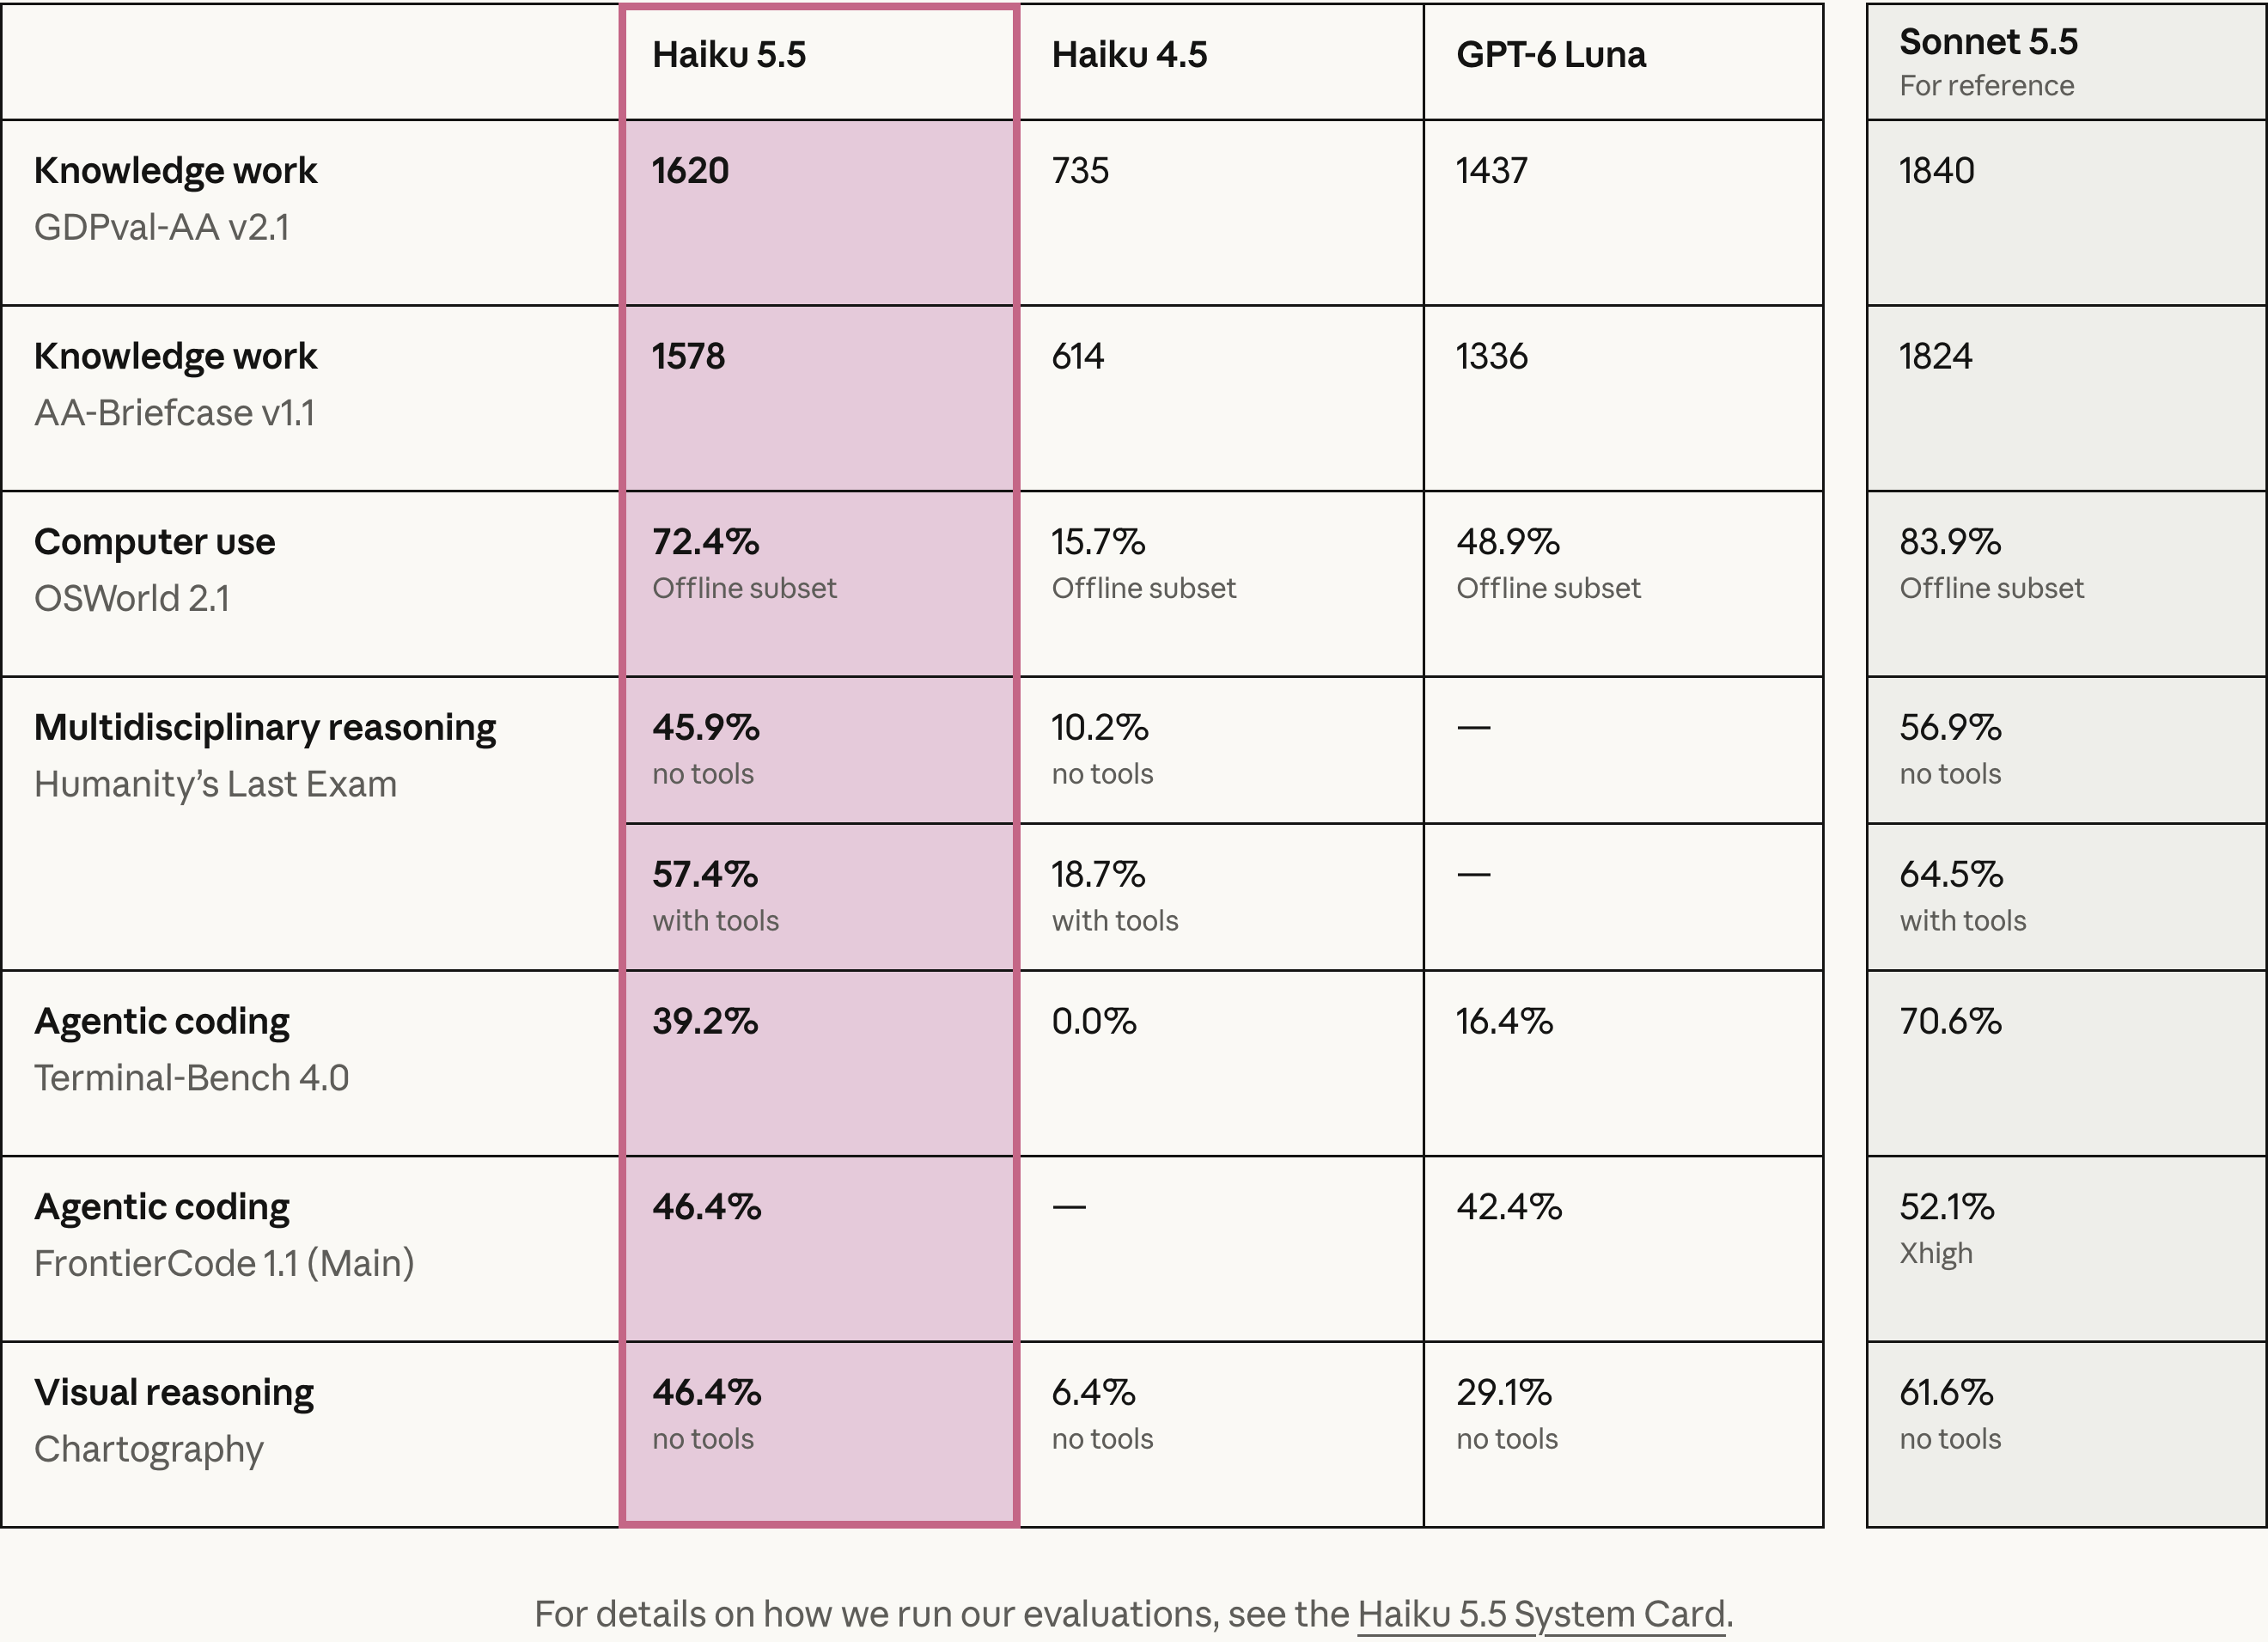
Fuente: anuncio oficial de Claude Haiku 5.5 — Anthropic, acceso 8 de octubre de 2026. Captura fiel de la tabla HTML que publica el propio sitio, sin modificaciones. Todos los valores son del fabricante; presentarlos no los valida.
Cómo leerla, siempre como resultados del vendor: Haiku 5.5 mejora a Haiku 4.5 en las siete filas comparables de las ocho que tiene la tabla (a Haiku 4.5 le falta valor en FrontierCode), con los saltos más llamativos en uso de computadora y código agéntico: 72,4% contra 15,7% en el subset offline de OSWorld 2.1, y 39,2% contra 0,0% en Terminal-Bench 4.0. Frente a Sonnet 5.5, en cambio, queda debajo en código agéntico complejo: 39,2% contra 70,6% en Terminal-Bench y 46,4% contra 52,1% en FrontierCode 1.1. Y frente a GPT-6 Luna — según los valores que publica Anthropic — queda arriba en las seis filas donde este tiene valor publicado: eso habla de la tabla del vendor, no de cargas de producción.
Las condiciones importan tanto como los números: OSWorld se mide en su subset offline; Humanity's Last Exam aparece en dos filas, sin herramientas y con herramientas; Chartography se mide sin herramientas; y en FrontierCode el dato de Sonnet 5.5 está anotado Xhigh, una condición declarada que impide asumir un effort idéntico en toda la fila. Los guiones (—) marcan celdas sin valor publicado: GPT-6 Luna no figura en Humanity's Last Exam y Haiku 4.5 no figura en FrontierCode; no son ceros.
Ver la transcripción completa de la tabla
| Evaluación | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 (ref.) |
|---|---|---|---|---|
| Knowledge work — GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| Knowledge work — AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| Computer use — OSWorld 2.1 (subset offline) | 72,4% | 15,7% | 48,9% | 83,9% |
| Razonamiento multidisciplinario — Humanity's Last Exam (sin herramientas) | 45,9% | 10,2% | — | 56,9% |
| Razonamiento multidisciplinario — Humanity's Last Exam (con herramientas) | 57,4% | 18,7% | — | 64,5% |
| Código agéntico — Terminal-Bench 4.0 | 39,2% | 0,0% | 16,4% | 70,6% |
| Código agéntico — FrontierCode 1.1 (Main) | 46,4% | — | 42,4% | 52,1% (Xhigh) |
| Razonamiento visual — Chartography (sin herramientas) | 46,4% | 6,4% | 29,1% | 61,6% |
Rótulos traducidos al español; los valores reproducen la tabla oficial del anuncio.
La nota al pie de la tabla remite al system card, que no pudo leerse al momento de escribir: no revisé evaluaciones independientes para esta nota ni claims de seguridad que trasladar.
El precio real: dos franjas, no un número único
La tabla oficial de precios tiene dos columnas, definidas por el tamaño del prompt. Precios en dólares estadounidenses por millón de tokens:
| Tipo de token | Prompt ≤100k | Prompt >100k |
|---|---|---|
| Input | US$0,10 | US$0,50 |
| Output | US$0,50 | US$2,50 |
| Cache read | US$0,01 | US$0,05 |
| Cache write (5 min) | US$0,125 | US$0,625 |
| Cache write (1 h) | US$0,20 | US$1,00 |
Para dimensionar: Haiku 4.5 figura en la página oficial a US$1/US$5 por millón de tokens, y Sonnet 5.5 a US$2/US$10. En la franja de hasta 100k, Haiku 5.5 cuesta una décima parte que su predecesor en entrada y salida.
La documentación suma dos palancas: el batch aplica 50% de descuento en entrada y salida, y el prompt caching cobra las lecturas repetidas a US$0,01 por millón en la franja baja — clave cuando el mismo system prompt viaja en miles de llamadas.
El umbral de 100.000 tokens no es un límite de contexto: es una franja de precio. El contexto es de 1 millón: podés mandar 400.000 tokens en un prompt; simplemente cada tipo de token se factura a 5 veces el precio de la franja baja.
Dos ejemplos hipotéticos de costo
Los números que siguen son hipotéticos, con valores redondos para mostrar el método. No son casos medidos.
Ejemplo A — clasificación de tickets. Supongamos 1.000 consultas diarias, con prompt de 20.000 tokens y respuesta de 200 (misma salida en ambos, para simplificar):
- En Haiku 4.5: 20.000 tokens × US$1/M = US$0,02 de entrada, más 200 × US$5/M = US$0,001 de salida: US$0,021 por consulta → US$21 por día.
- En Haiku 5.5: el mismo texto pesa ~30% más (aproximación oficial), unos 26.000 tokens: US$0,0026 de entrada más US$0,0001 de salida → US$2,70 por día.
Unos 87% menos, en la misma dirección del ~75% promedio que estima Anthropic y que depende de tu mezcla de uso. Con caching sobre el system prompt repetido, cada lectura sale US$0,01 por millón y el ahorro crece.
Ejemplo B — resumen de un expediente largo. Supongamos un prompt de 300.000 tokens y salida de 2.000. Como el prompt supera los 100k, la tabla pasa a la columna cara: 0,3 M × US$0,50 = US$0,15 de entrada, más 2.000 tokens × US$2,50/M = US$0,005 de salida → US$0,155 por consulta.
La misma aritmética a precios de la franja baja daría US$0,031: cruzar el umbral multiplica el costo por 5. El contexto de 1M es una capacidad, no una invitación: si tu carga vive arriba de 100k tokens por prompt, evaluá fragmentación, resúmenes incrementales o caching.
La tokenización: el mismo texto pesa más
Hay un costo que no aparece en la tabla: la documentación oficial estima que un mismo texto ocupa aproximadamente 30% más tokens en Haiku 5.5 que en Haiku 4.5. La cifra varía por contenido, pero cambia el cálculo: cobrás esos tokens a precio de 5.5 aunque el texto sea el mismo.
La evidencia independiente apunta en la misma dirección: en un prompt largo, Willison midió con el contador de tokens unos 1,25x los tokens de Haiku 4.5. No son métodos comparables — aproximación general del vendor contra un caso único e independiente — pero la lección presupuestaria es la misma: no estimes el costo de 5.5 con los tokens de tu modelo anterior. Es el criterio de costo por tarea completa que aplicamos en el análisis de Gemini 3.8 Flash.
Effort y latencia: lo que el precio por token no muestra
El effort ajustable mueve latencia y consumo. Haiku 5.5 es el primer Haiku que permite configurarlo — medium por defecto; la documentación revisada confirma el ajuste de esfuerzo, pero no justifica asumir que pueda desactivarse. El dato ilustrativo viene de Willison: en su clásica prueba del SVG con un pelícano, el modelo tardó ~7 segundos con effort bajo y ~5 minutos y 9 segundos al máximo. El autor aclara que no es un benchmark general de latencia, y así hay que tomarlo: mide un caso extremo, no tu carga.
La lección sí es general: el modelo más barato de la familia puede volverse lento al máximo effort, que se paga en tiempo y en tokens generados. Sumale los reintentos: el precio de la tabla no incluye la llamada que falló. En alto volumen, ese es muchas veces el componente del costo que nadie midió.
Haiku 5.5 frente a Sonnet 5.5 y Opus: la frontera que dibuja el vendor
La segmentación no es nuestra: es la guía del fabricante. Sonnet y Opus siguen siendo mejores para código agéntico complejo, indica Anthropic, que posiciona a Haiku 5.5 para tareas acotadas. En lista: US$0,10/US$0,50 contra US$2/US$10 de Sonnet 5.5, con Opus por encima.
Mi criterio práctico:
- Haiku 5.5: tareas cortas, definidas y de alto volumen, con respuesta verificable — clasificar, extraer, resumir, routear, soportar.
- Sonnet: código real y agentes con herramientas, donde el costo por llamada se justifica en calidad.
- Opus: los casos difíciles de varios pasos donde fallar es caro.
Elegir entre modelos de una familia — o entre familias — es un problema de tarea y precio: el método de la comparativa de Fable 5, Opus 4.8 y Sonnet 5 y de GLM-5.3 vs GLM-5.3-Flash.
Checklist de migración y evaluación
Si pensás migrar carga a Haiku 5.5, el mínimo que evaluaría antes de mover tráfico real:
- Armá un set propio de tareas reales — 20 a 50 casos con resultado esperado, no ejemplos del anuncio.
- Medí calidad con el mismo contexto e instrucciones en Haiku 4.5 y 5.5 — y en Sonnet si tu caso roza lo complejo. La evidencia del vendor no reemplaza tu evaluación.
- Contá tokens reales por tarea: la tokenización puede alejarse del ~30% oficial según tu contenido.
- Medí latencia en el effort que vas a usar, no en el que viene por defecto.
- Sumá reintentos y errores al costo total: una llamada que falla también se paga.
- Revisá cuántos de tus prompts superan los 100k tokens antes de calcular el ahorro con la franja baja.
- Si la carga tolera latencia, probá el batch: 50% menos en entrada y salida.
- Definí un fallback a Sonnet u Opus para los casos donde Haiku falle.
Si querés una segunda mirada para diseñar esa evaluación, la página de contacto es el canal directo.
Preguntas frecuentes
¿Cuánto cuesta Claude Haiku 5.5?
US$0,10 por millón de tokens de entrada y US$0,50 de salida cuando el prompt no supera los 100.000 tokens. Al superar ese umbral, la tabla oficial pasa a US$0,50 y US$2,50. Las lecturas de caché cuestan US$0,01 (franja baja) y US$0,05, y el endpoint batch aplica 50% de descuento en entrada y salida.
¿Claude Haiku 5.5 reemplaza a Sonnet u Opus?
No. Según la propia guía de Anthropic, Sonnet y Opus siguen siendo mejores para código agéntico complejo. Haiku 5.5 apunta a tareas acotadas de alto volumen: resúmenes, compactación de contexto, consultas a bases de datos, clasificación, soporte en vivo y subagentes de código acotados.
¿Por qué el mismo texto ocupa más tokens en Haiku 5.5?
La documentación oficial estima que un mismo texto ocupa aproximadamente 30% más tokens que en Haiku 4.5. En un experimento independiente con un prompt largo, Simon Willison midió 1,25x. La cifra exacta varía por contenido: conviene medir los tokens reales de tu carga antes de estimar costo.
¿El umbral de 100.000 tokens es un límite de contexto?
No. El contexto de Haiku 5.5 es de 1 millón de tokens. Los 100.000 definen la franja de precio: cuando el prompt supera esa marca, la tabla oficial pasa a la columna más cara, con precios 5 veces mayores para cada tipo de token.
Fuentes consultadas
- Anuncio oficial de Claude Haiku 5.5 — Anthropic (posicionamiento, precios, benchmarks vendor-reported, disponibilidad). Acceso: 8 de octubre de 2026.
- Documentación oficial del modelo — Anthropic (contexto, output, effort, tokenización, caché y batch). Acceso: 8 de octubre de 2026.
- Claude Haiku 5.5 — Simon Willison, 7 de octubre de 2026 (fecha de lanzamiento y experimentos independientes).
- Portada: imagen oficial de Anthropic rehosteada sin modificaciones. Fuente: Anthropic. La procedencia oficial no es una licencia de reuso.

Especialista en Agentes de IA · Copenhague
Diseño e implemento agentes IA, MCP servers y harnesses en producción: el loop, las herramientas y el contexto que hacen que un modelo pase de contestar a trabajar. Todo lo que ves en este sitio está construido así.
Artículos relacionados
Claude Buddy: Guía Completa del Tamagotchi de Claude Code (18 Especies y Rarezas)
Claude Buddy: las 18 especies, 5 rarezas, comandos /buddy y cómo conseguir un Shiny Legendary (0.01% de probabilidad). Guía completa en español.
Claude Opus 5.5: precio, benchmarks y guía de migración
Claude Opus 5.5 cuesta $4/$20 por MTok, 20% menos que Opus 5. Precios completos, benchmarks reportados por Anthropic, los cuatro breaking changes y una checklist de migración.
Claude Academy: cómo migrar tu progreso desde Skilljar
Claude Academy reemplaza la academia pública de Skilljar. Explico qué progreso se importa, qué certificados siguen vigentes y cómo migrar con continuidad.